Step5 Preview 在 SGLang 上的实现:稀疏注意力、新 kernel 与 SM90/Blackwell 分叉
Step5 Preview 在 SGLang 上的实现:稀疏注意力、新 kernel 与 SM90/Blackwell 分叉
- 代码基准:
sgl-project/sglang分支step5-preview-support,提交dfcafb2d95(核心功能来自6dd8650d4f Step 5 Preview Support)。本文所有行号以该提交为准。 - 官方博客:Step 5 Preview: Day-0 Inference and RL Support with SGLang and Miles
- StepFun 贡献的 sparse attention kernel 位于
python/sglang/kernels/ops/attention/step5/cute/sm100_union/。
TL;DR
Step5 Preview 是个 600B 总参数 / 27B 激活的多模态 MoE 模型。对推理引擎来说,它有三件事同时发生:稀疏专家(352 选 8)、混合注意力(3 层滑窗 + 1 层稀疏)、MTP 投机解码(3 层 draft)。三者叠加之后,SGLang 这套实现的形状和普通 dense 模型差得相当远。
值得先记住的几件事:
- 92 层严格 3:1:每 4 层一组,前 3 层是 window=512 的 sliding-window attention(SWA),第 4 层是 sparse attention(下文按代码叫 DSA 层)。也就是 69 层 SWA + 23 层 DSA。
- DSA 不在原始 token 上选。indexer 先把 8 个 token 的 K 压成一个 256 维的 key,存成 E4M3 字节,然后在这些"压缩 key"上给每个 query 打分,选出 top-512 个 8-token region,再加上当前 region,一共 513 个,最后只在这些 region 的原始 K/V 上做 attention。
- 一次 DSA forward 是双路并行的:主路是 QKV(+gate)投影,旁路是 indexer 的四个投影 + 压缩 + 打分 + 选择。选择结果是
packed int64 [T, 513],两路在稀疏 attention kernel 处汇合。 - prefill 和 decode 是两套完全不同的稀疏策略:prefill 把一组 query 选中的 region 求并集,在并集上跑一次 attention,再用 per-query mask 精筛;decode 则把长历史切成 1/2/4 个 partition 并行算,最后按 LSE 合并。
- 同一份 Python 前端,三套 kernel 后端。SM90(H200)走 CuTe/WGMMA + Triton scoring + FlashInfer top-k;Blackwell(SM100/SM103)走 CuTe/tcgen05(Tensor Memory,TMEM)+ CuTe stable top-k 或 DeepSelect;SM103(B300)再额外开一批融合。
- 官方数据:4×GB300、TP4、MTP 接受长度 2.85 时,单请求 decode 约 299 tok/s;MegaMoE 在 64 并发下约 740 output tok/s/GPU,128K prefill 约 11,440 tok/s/GPU。
读代码时可以直接按这张表跳转:
| 关注点 | 入口 |
|---|---|
| 配置与硬校验 | python/sglang/srt/configs/step5.py |
| 模型 / 注意力 / MoE | python/sglang/srt/models/step5.py |
| MTP draft 层 | python/sglang/srt/models/step5_mtp.py |
| attention backend | python/sglang/srt/layers/attention/step5_backend.py |
| indexer | python/sglang/srt/layers/attention/step5/indexer.py |
| 各类 kernel | python/sglang/kernels/ops/attention/step5/ |
| KV pool | python/sglang/srt/mem_cache/step5_kv_pool.py |
1. 模型侧:有些数字是写死的
1.1 一份 profile,一个 11 元组
Step5Config 没有跟着 HF config 走,而是把注意力几何全部从 config 里解析出来,再跟一个常量 profile 逐项比对(parse_step5_attention_profile):
| 项 | 值 | 说明 |
|---|---|---|
hidden_size |
4096 | 残差流宽度 |
head_dim / num_heads |
192 / 64 | Q 头数与维度 |
num_kv_heads |
4 | GQA,16:1 |
index_head_dim / index_num_heads |
256 / 16 | indexer 的 head 维度与头数 |
provider_groups / region_size |
4 / 8 | indexer 分片组数 / 压缩粒度 R8 |
index_rope_dim |
32 | 压缩键只转 32 维 RoPE |
sliding_window |
512 | SWA 窗口 |
校验失败时抛的是同一句话:
1 | |
这不是"默认值",而是 kernel 的 ABI。翻开 prefill_sm103.py、decode_sm103.py 的文件头就能看到 HEADS = 8、DIM = 192、QUERY_GROUP = 16、PAGE_SIZE = 16、SUPPORTED_LOGICAL_Q_HEADS = (8, 16) 这类常量。kernel 里 block_n=64、page 64、region 8 都是硬编码,所以前端必须在加载期就把不合法配置拦下来。
同一段代码里还有两条更细的硬约束:
- FP32 的 Gemma norm 权重 +
zero_centered=True+use_head_wise_attn_gate=True,三个缺一不可; - indexer 的归一化类型被写死成 q 用 RMSNorm、k 用 LayerNorm、z 不归一化(
sparse_indexer_q_norm_type="rmsnorm"/k_norm_type="layernorm"/csa_z_norm_type="none")。
1.2 两套 RoPE 参数
full_attention 和 sliding_attention 的 RoPE 完全不同(configs/step5.py#L576:L592):
1 | |
于是 step5_qknorm_rope 必须同时支持 rotary_width in (64, 192) 两种形状,CuTe 编译也按这两个宽度分别特化。DSA 层只让 1/3 的通道带位置信息,剩下的 128 维是位置无关的——这跟"先压缩再打分"的设计是一致的:压缩键本身已经丢掉了 token 级细节,位置信息只需要一个粗粒度提示。
1.3 head 的切分方式
TP 的切法有两层,容易搞混:
- attention:64 个 Q 头按 TP 均分,TP4 每 rank 16 头、TP8 每 rank 8 头;4 个 KV 头在 TP4 下正好每 rank 1 个,所以 K/V 只按头切分,不存在 head 维度内的切分。
- indexer:16 个 index 头按
index_tp_size=4切成 4 组(provider_groups)。Step5Indexer的注释写得很清楚——“Provider-sharded Q/W, replicated K/Z”,即 Q、W 沿 provider group 切分,K、Z 是ReplicatedLinear每 rank 都算一份。TP8 时provider_rank = tp_rank // 2,两个相邻 rank 共用同一组 index 头。
这也解释了 weight_scale = num_heads**-0.5:TP4 下每 rank 4 个 index 头,缩放因子正好 0.5。
1.4 MoE 与 MTP
MoE 侧两个细节值得单独记:
- router 精度:
Step5Router.compute_logits用 BF16 权重算 GEMM 但强制out_dtype=torch.float32(step5.py#L230:L236)。Step5RouterTopKOp里 sigmoid 后的 correction bias 只参与 top-8 选择,最终权重用的是未加 bias 的 sigmoid,按选中顺序求和、加1e-20兜底再乘3.0。这个"选择用带偏置、加权用不带偏置"的顺序是模型语义的一部分,不能用普通的topk_softmax替代——所以 SGLang 专门注册了RoutingMethodType.SigmoidBiasOrderedRenorm。 - 激活:shared expert 用 BF16 SwiGLU,但激活函数是带 clamp 的版本
SiluClampAndMulOp,计算min(silu(g)*g, L) * clamp(up, -L, L)(L 为swiglu_limit)。FusedMoE 侧对应的开关是silu_clamp_mode="post"+fc1_output_dtype="bf16"+gemm1_clamp_limit。
checkpoint 有个坑:quant_config.ignored_layers 里排掉了部分层的专家矩阵,_step5_keep_bf16_experts() 会把这些层保留成 BF16,除非显式设置 SGLANG_STEP5_QUANTIZE_BF16_MOE=1。官方 benchmark 的描述也是 “FP8 routed experts (BF16 in the last three MoE layers)”。
MTP 是 3 个独立的 draft model,每层结构相同(Step5DraftModel):
1 | |
注意 hnorm 的输入是上一层返回的 FP32 hidden,而 eh_proj 是 BF16 的。所以 Step5Model.forward 返回 (normalized, hidden_states.float())——把 BF16 累加结果再展成 FP32 交给下一 depth。另外 Step5MTP 上有 kv_cache_dtype_full_attention_only = True,意思是 MTP 的 KV cache dtype 只跟随 full-attention 层的设置;而 MTP 层本身是 dense 的 SWA 层(layer_id 落在 moe_layer_list 之外,否则直接 raise)。
2. 混合注意力:一条 is_dsa 分出两条路
2.1 一个布尔值决定后端
Step5Attention 里最关键的一行是:
1 | |
DSA 层的 sliding_window_size 是 -1(不设窗口),SWA 层是 511。而在 backend 侧,Step5AttentionBackend.forward_decode / forward_extend 第一件事就是查 layer.layer_id in self.token_to_kv_pool.dsa_layer_ids:不是 DSA 层就整包转给 swa_backend(FA3 或 FA4),是 DSA 层才进入 _forward_dsa。
也就是说:69 层 SWA 走的是通用 FlashAttention 路径,23 层 DSA 走的是本文后面要说的一整套专用 kernel。
SWA 层顺便吃了三个融合,都在 Step5Attention.forward 的 is_dsa == False 分支里:
swa_kv_write_target()拿到目标页地址后传给step5_qknorm_rope,qk-norm + RoPE 与 KV 写入被合并成一个 kernel(SWA_FUSED_QKNORM_STORE);supports_swa_head_gate()为真时,head gate 直接折进 FA4 的 epilogue(SWA_FA4_GATE_EPILOGUE);- FP8 KV 时 per-token scale 通过 attention kernel 的参数传入,不做额外量化 kernel。
2.2 官方架构图
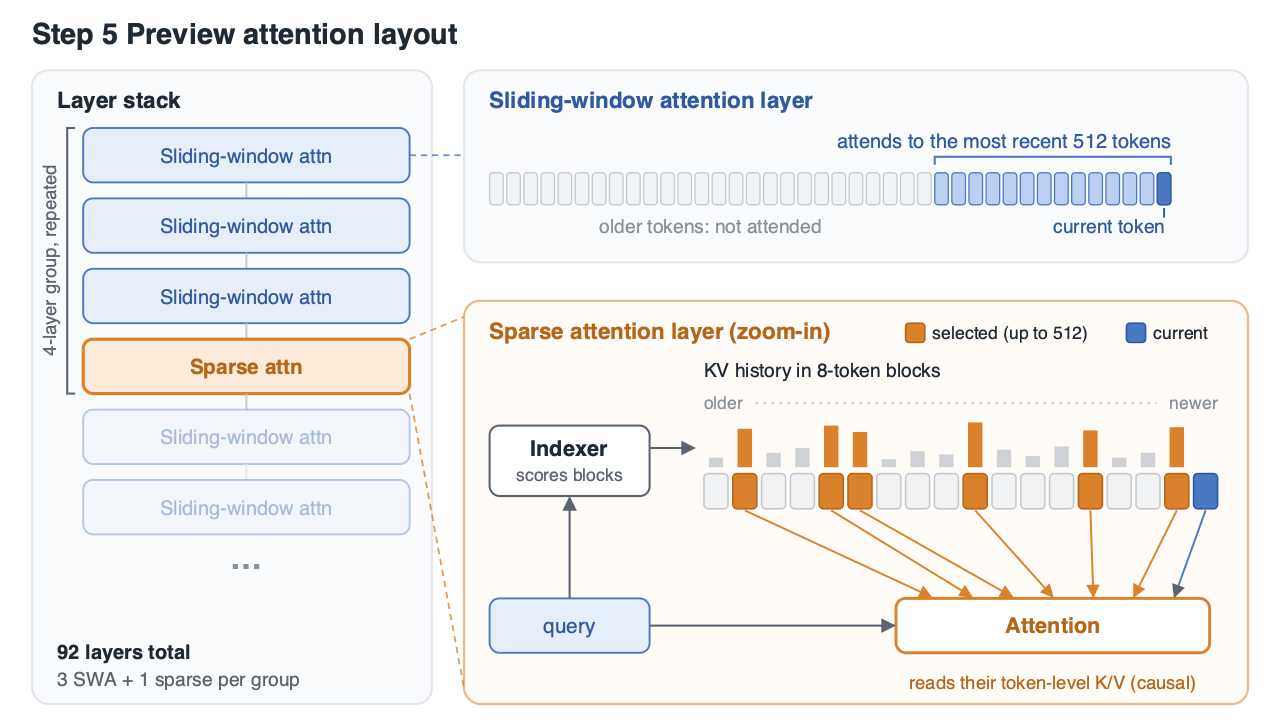
三组 sliding-window 层 + 一组 sparse 层循环出现;sparse 层里 indexer 先给 8-token block 打分,attention 只读被选中的 block 和当前 block。
2.3 一个 DSA 层 forward 的完整时序
左列是主链(QKV + gate),右列是 indexer 旁路;两路在稀疏 attention 处汇合。橙色只标记整个 DSA 层的核心节点。
下面按执行顺序拆开,每一步都给出实际的 tensor 形状(以 TP4、decode/verify 的小 batch 为例,T 是 packed query 行数,H 是每 rank 的 Q 头数 = 16)。
第一步:QKV + gate。 qkv_proj 是 QKVParallelLinear,g_proj 是 ColumnParallelLinear。SM103 上还多一条路:把两个权重拼成 qkv_gate_weight,一次 GEMM 同时得到 QKV 和 gate(step5.py#L920:L946):
1 | |
宽度可以自己算一遍:TP4 下 Q 是 16×192=3072,K 和 V 各 192,合计 3456;再加 16 个 head 的 gate,3472。TP8 则是 8×192+384=1920,再加 8,1928。融合后由 step5_qknorm_rope_gated 直接从这一块 buffer 里切出 q/k/v/gate,省掉一次独立的 gate GEMM 和一次 kernel 启动。
第二步:indexer 四投影(旁路)。 sparse_indexer_q/k/z 加 sparse_indexer_w。SM103 上 q/k/z 三个权重也被拼成 qkz_weight (1536, 4096)——1024 行 Q + 256 行 K + 256 行 Z——一次 GEMM 出全部,再 split((1024, 256, 256), dim=-1)。W 的 M 很小(等于 token 数),单独走 tiny_gemm_bf16(indexer.py#L125:L172)。
注意这条旁路不是所有时候都并行:use_alt_stream 要求 forward mode 是 decode / target_verify / draft_extend_v2,且行数 0 < T <= dsa_overlap_max_rows(SM103 上是 256,其它平台 255)。prefill 的时候 indexer 是同步跑的。
第三步:step5_indexer_norm_rope。 输入 index_q [T, 4, 256]、index_key [T, 1, 256]。q 过 GemmaRMSNorm、k 过带 bias 的 LayerNorm、z 原样透传,然后只对 32 维做 RoPE。同一个 kernel 里还能顺手做两件事:
fold_indexer_scale=True(SM103 默认)时把1/sqrt(4)=0.5折进 Q,后面的打分就不用再乘;fuse_indexer_fp8_cast=True时直接把 Q 转成 E4M3 输出,给 scoring kernel 当输入(_cuda_fp8_saturates()会先探测一下 0x7E/0x7F 的 satfinite 行为再决定要不要开)。
第四步:compress_index_keys。 见 2.4。
第五步:step5_paged_scores。 在压缩键上打分,得到 FP32 的 [T, ceil(pos/8)]。见 2.5。
第六步:region selection。 top-512 历史 region + 当前 region,打包成 int64 [T, 513]。见 2.6。
第七步:稀疏 attention。 decode 走 split + merge,prefill 走 union + mask。见 2.7、2.8。
第八步:head gate + o_proj。 _apply_head_gate 调用 fused_sigmoid_mul(..., round_gate=True),把 per-head 的 sigmoid 门乘到 attention 输出上,再 output.flatten(1) 进 o_proj(RowParallelLinear + TP all-reduce)。
2.4 CSA R8:8 个 token 怎么变成一个 key
压缩是 DSA 能省算力的根源,也是整个实现里最容易算错的部分。
_compressed_index_key_bytes 做的事,用一句话说:对 8 个 token 的 z logits 做 softmax,用这个权重对 8 个 k 加权平均,BF16 舍入后转成 E4M3 字节(csa_ring.py#L30:L77)。kernel 侧是一个标量最大值贯穿 8 个 token、256 个 channel,然后在 offset 顺序上累加加权 K 和权重,用 1e-20 做分母下限,最后 FP32 -> BF16 -> E4M3 RN satfinite(cvt.rn.satfinite.e4m3x2.f32)。
存储侧的形状很关键:
| buffer | 形状 | dtype |
|---|---|---|
compressed_index_key_buffer |
[layers, pages, 8, 1, 256] |
uint8(E4M3 字节) |
index_key_ring |
[layers, req_slots, ring_size, 1, 256] |
BF16 |
compression_logits_ring |
[layers, req_slots, ring_size, 1, 256] |
BF16 |
index_position_buffer |
[layers, ...] |
int64 |
8 这个维度就是 R8:一个 64-token 的 page 正好装 8 个 region,压缩键与 FULL pool 的物理页一一对齐,所以打分时不需要额外的地址映射——req_to_token[request, 8*r] 就是第 r 个 region 的物理起点。
ring buffer 负责"还没凑满 8 个 token"的情况。容量是 get_step5_ring_capacity(max_verify_width):
1 | |
因为 verify 一次会推进 verify_width 个 token(MTP topk=1 时是 4),最坏情况下要从"差 7 个"开始,所以需要 R-1+width 个槽位再向上取整到 R 的倍数。index_ring_size 默认 8,必须是 R 的整数倍。
还有一个容易忽略的顺序约束:append_ring 必须先读旧 ring,再把本次输入发布进去。代码注释写得很直白——“Read the old ring before publishing this forward’s pending inputs”。否则同一个 token 会被重复计入压缩。
2.5 scoring:为什么需要 512 MiB 的 workspace 预算
step5_paged_scores(scoring.py#L43)的接口约束写得非常细:
1 | |
几个数值细节:
- 权重缩放。FP32 权重被认为是已经乘过 head 数的(
weight_scale=1);BF16 权重是原始 GEMM 输出,默认weight_scale=0.5(注释里写的是精确值4**-0.5)。如果 SM103 把 0.5 折进了 Q,这里就传weight_scale=None让 dtype 决定。 - group_rows ∈ (1, 4, 32)。32 行共享同一个 request slot 是 SM100 tile 的硬约束,kernel 里用
_assert_group32_ownership在设备侧断言——“Group-32 rows must share one request slot or be padding”。 - workspace 预算。
STEP5_SCORE_WORKSPACE_ELEMENTS = 128*1024*1024,也就是 512 MiB 的 FP32 打分空间。selection_tile_rows(rows, score_width)按这个预算把 query 行切 tile:
1 | |
上下文越长,score_width = ceil(context/8) 越大,一个 tile 里能塞的行就越少。这是长上下文下 selection 的主要调度自由度。
2.6 selection:512 + 1 = 513
select_step5_regions 产出三个东西:packed、counts、lengths。其中 packed 是 int64 [T, 513],打包方式在 step5_pack_decode_regions 里:
1 | |
一个 int64 同时装下物理地址和逻辑地址,稀疏 kernel 读一个数组就够了,不用再查表。为什么是 513 而不是 512?因为"当前 region"总会无条件追加一次——它是唯一一个可能不完整的 region,因果性由 causal_lengths 单独给出。
三个实现分支(region_selection.py#L147:L273):
| 分支 | 判据 | 实现 |
|---|---|---|
| packed Q/W | 打分元数据已就绪且只有一个 tile | launch_prepared_scoring |
| prefill plan | prefill 且 heads==4,能建出 build_step5_prefill_scoring_plan |
step5_prefill_scores |
| 通用 | 其它(含 decode) | step5_paged_scores + 选一个 selector |
selector 本身也有三套:
selection_cute.py:SM10x 专用,_TOPK=512、_THREADS=512。先做一次单调 key 变换(_ordered_key:正数bits ^ 0x80000000、负数~bits、NaN 映射到最大 key),再用 warp scan + atomic 计数做稳定排序,tie保持原 region 顺序,结果直接 pack 进 int64;selection_deepselect.py:把STEP5_HISTORY_REGIONS = 512个历史 region 交给deep_select_topk,只在 capability 10.x 可用;selection.py:可移植路径,SM90 走 FlashInfer 的top_k(deterministic=True, tie_break=1, dsa_graph_safe=True),再用 Triton pack。
注意 dsa_graph_safe=True 这个参数——选择过程要能在 CUDA Graph 里 replay,任何需要 host 读设备值、或者输出形状依赖数据的写法都不行。
2.7 sparse prefill:union + membership
这是 StepFun 贡献 kernel 的核心思路,也是 prefill 阶段唯一能"批量复用"的地方。
问题在于:一组 query 各自选了 512 个 region,但它们选的 region 大概率重叠。如果每个 query 各算各的,K/V 的加载和 block 级 reduction 都会重复。所以做法是(step5_build_prefill_union):
- 取 最多 16 个 query 为一组(TP8 是 16,TP4 是
128/16 = 8,由query_group = min(16, 128 // heads)决定); - 把组内所有 query 选中的 region 求并集,得到
union_physical [G, C]/union_logical [G, C]/union_counts [G]; - 同时记下
membership [G, C]——第 j 位表示"第 j 个 query 选了它"; - attention 只在并集上跑一遍(block 级 K/V 只加载一次),再用 membership + token 级因果掩码把不属于本 query 的部分屏蔽掉。
membership 的语义在注释里被反复强调:“Bit j denotes selection by query slot j, not permission for all queries to attend the union.” 换句话说它是个"精确筛子",不是"共享许可"。union 只是省了重复加载,算力该省的还是要省。
容量上界由两处夹住:
1 | |
region_bins 同时被 bitset workspace 用([G, ceil(region_bins/32)],int32)。backend 的 _allocate_attention_buffers 就按 min(16*513, region_bins) 分配 union buffer。
prefill 的另一个细节:kernel 接收的是 query_positions [T](逻辑位置),而不是 packed 行号。因为 membership 是按逻辑位置组织的,packed 行号只是为了把变长 batch 塞进一个连续 buffer。
2.8 sparse decode:split + merge
decode 阶段每个请求只有很少的 query 行(MTP topk=1、3 step 时是 4 行),但每行的 513 个 region 是实打实的 513×64 个 token。4 行 query 根本喂不饱几百个 SM,所以要把历史切开。
调度函数有两个(sparse_decode.py#L38):
step5_sparse_decode_plan(rows, sm_count, max_split=4):通用版本,按行数和 SM 数决定 1 / 2 / 4 路切分;step5_sparse_decode_sm103_plan(rows, sm_count):rows 已经 ≥ SM 数时,固定 1 CTA/row,不再切。
build_step5_sparse_decode_schedule 里还有一条动态规则:
1 | |
16 是单个 query 行的 split 上限(split_capacity=16 if dynamic_splits else 1),所以 4 行 verify 展开成 work_rows = 16 × 4 = 64 个工作行——这正是 supports_dsa_head_gate() 里 decode_work_rows == 64 的来历。kernel 注释解释了为什么是 16:“Four MTP verify rows provide enough independent work to use the full 16-way split capacity on a 148-SM L20D. Eight-way splitting leaves most SMs idle while every CTA still processes eight K/V tiles.” 换句话说,8 路切分下每个 CTA 仍要吃 8 个 K/V tile,SM 却空了一大半。
纯 decode(mtp_q_len == 1)不是固定 16 路:kernel 先数出实际活跃行数,再由 _target_split_parts(active) 反过来决定切几份。有投机 verify 时用固定上限,没有时按行数自适应。
partial 输出之后要合并。合并走 merge_dynamic_split_nat_lse_states_sm90_gqa / merge_variable_split_nat_lse_states_sm90_gqa,按 natural-log 的 FP32 LSE 做加权:
1 | |
两个细节:LSE 必须是 natural log 且 FP32(lse [T, H],TP4 下 H=16);merge kernel 还支持在合并时顺手把 head gate 乘上去(merge_dynamic_split_nat_lse_states_sm90_gqa(..., head_gate=...))。文件名叫 sm90_gqa 是历史原因,SM100/103 也在用。
2.9 head gate:两个位置,一个公式
head gate 的公式只有一行:out *= sigmoid(gate)。但它在实现里有两个落点:
- 常规路径:attention 输出后调
_apply_head_gate,走fused_sigmoid_mul(out, gate, round_gate=True); - SM103 verify 路径:直接折进 decode kernel 的 epilogue,attention 结果还在 TMEM/寄存器里就乘完,省掉一次读回。
第二个落点的门槛写在 supports_dsa_head_gate:
1 | |
这些条件缺一不可:必须是 decode、必须是动态 split、必须 4 行 query × 16 路(work_rows == 64)、必须 TP4 的 16 头(attention_shape == (16, 192) 且 lse.shape == (4, 16))、必须 B300。前面的 Step5Attention.forward 还会再确认 forward_mode.is_target_verify() + rows == 4 + dtype == bf16。所以这个融合只服务于 MTP verify 那一步——恰好也是最需要省 kernel 启动的地方。
3. 新引入的 kernel 地图
先给全景。下表按"一个 DSA 层 forward 走过哪些 kernel"排列,右两列是平台分叉:
| 阶段 | 入口函数 | SM90 (H200) | Blackwell (SM100/103) |
|---|---|---|---|
| qk-norm + RoPE | step5_qknorm_rope(_gated) |
CuTe(支持 capability 9) | CuTe |
| indexer 投影 | Step5Indexer.forward |
4 次 Linear | QKZ 打包(SM103) |
| indexer norm+RoPE | step5_indexer_norm_rope |
Triton | Triton + FP8 cast(SM103) |
| R8 压缩 | compress_index_keys / step5_csa_region |
Triton | Triton |
| 打分 | step5_paged_scores |
scoring_triton |
scoring_sm100(tcgen05) |
| 选择 | step5_select_regions* |
FlashInfer top-k + Triton pack | selection_cute / DeepSelect |
| prefill | step5_sparse_prefill |
WGMMA union kernel | sm100_union / SparsePrefillSm103 |
| decode | step5_sparse_decode_partials |
WGMMA 64-GQA | SparseDecodeSm103(TMEM) |
| 合并 | merge_*_nat_lse_states |
CuTe | CuTe |
| head gate | fused_sigmoid_mul |
elementwise | elementwise / decode epilogue |
3.1 全都是 CuTe DSL 编译出来的
新 kernel 有一个共同的形态:用 CuTe DSL 写在 Python 里,运行时现场编译。入口都是 cute.compile(kernel, fake_tensor..., options="--enable-tvm-ffi --opt-level 2"),用 make_fake_tensor 描述形状,行数这类维度用 cute.sym_int() 留成动态,只有 union_capacity、logical_q_heads 这种影响 layout 的维度才做特化。
1 | |
这带来两个工程后果:
- 编译缓存必须持久化。官方文档说首次启动要编译 FlashInfer 模块约 15 分钟(B300),后续约 6 分钟,
~/.cache/sglang和FLASHINFER_WORKSPACE_BASE要跨重启保留。 - 形状必须提前 warm up。所有入口的注释都在强调 “Warm compilation before capture; this entry allocates no CUDA storage and performs no host reads of device values”——因为要进 CUDA Graph,kernel 里不能有 host 同步。
3.2 prefill:三代 kernel 并存
step5_sparse_prefill(sparse_prefill.py#L23)是个分发器,按 use_sm100_sparse_prefill() 和有没有 workspace 分成三条路:
sm100_union(capability 10.x,prefill 必定带 workspace)。来自 StepFun 的贡献,目录里带README.md和MANIFEST.json记录来源 commit。入口是token_wise_flash_attn_prefill_union_sm100_gqa_func,参数里能看到它需要的全套元数据:union_counts、union_phys_indices、union_logical_indices、exact_mask_bits、causal_limits、work_q_global、work_q_local、work_q_len,外加一个Sm100UnionExactPrefillWorkspace。workspace 里的sm100_block_indices是预先算好的 block 序号(arange(capacity/16 + 2)),sm100_region_words的形状是[G, blocks, 128/heads],最后一维正好对上 group 大小。compile_prefill_sm90(Hopper)。kernel 类_TokenWiseSparsePagedPrefillUnionGQA,参数block_n=64、num_threads=512、q_group=128 // logical_q_heads、max_union_windows=union_capacity、per_query_positions=True。compile_prefill(10.x 无 workspace 时的回退)。kernel 类SparsePrefillSm103,文件头写着这是 “vLLM Step5’s grouped-union sparse paged prefill” 的 SM103 移植,拓扑是 “512-thread producer / two-consumer”,常量HEADS = 8、DIM = 192、QUERY_GROUP = 16。
第 1 条和第 3 条只在"有没有 SM100 workspace"上分叉,use_sm100_sparse_prefill() 本身只看 capability[0] == 10,而 _allocate_attention_buffers 在 10.x 的 prefill 上一定会把 sm100_* 那几块 scratch 建出来。所以 B200 和 B300 的 prefill 默认都走 sm100_union。
还有一个侧面证据说明 prefill 不需要 split-kv:SM100 prefill 路径下 lse 直接是 None(lse = None if not decode and use_sm100_sparse_prefill() else ...)。union kernel 一次算完,根本没有 partial 要合并,自然也不需要输出 LSE。
3.3 decode:WGMMA 的寄存器累加 vs tcgen05 的 TMEM
decode 的两套实现差异最能体现两代架构的区别(decode_dispatch.py):
| SM90 | SM100 / SM103 | |
|---|---|---|
| kernel 类 | _TokenWiseSparseDecodeWGMMA64GQA |
SparseDecodeSm103 |
| MMA | WGMMA,swap-AB | tcgen05(UTCCP) |
| 累加器 | 寄存器 | TMEM |
| 同步 | warpgroup 同步 | tcgen_after_sync / tcgen_before_sync |
| split 容量 | split_capacity=16 or 1 |
同 |
decode_sm103.py 的头注释一句话点破:“TMEM copy coordinates replace WGMMA register ownership.” Hopper 上 accumulator 归 warpgroup 所有,tile 能开多大直接受每线程寄存器预算约束,所以 SM90 版本用 swap-AB 的 WGMMA 把 K/V 摆到合适位置,靠寄存器堆累加;Blackwell 把 accumulator 搬进 TMEM,MMA 的坐标变成"复制坐标",累加结果不再占寄存器。
两边的 num_threads=256、block_n=64 看起来一样,但内部流水是完全独立的两套实现——不是同一份代码换个指令。
3.4 scoring 与 selection
打分在 Blackwell 上也有专门实现(scoring_sm100.py),文件头几个常量直接说明了 QKV 的布局假设:
1 | |
MTP_QUERY_CAPACITY = 4 和前面 head_gate.shape == (4, 16) 是同一个 4——MTP topk=1、3 步投机,verify 一次正好 4 行。
selection 侧,selection_cute.py 实现的是一个稳定 top-512:先把 FP32 分数的位模式重排成可比较的 uint32 key(_ordered_key,把负数映射到正确顺序),再做 warp 级 scan + atomic 计数(_warp_scan、_atomic_add),最后 _store_region 直接写 int64。稳定排序在这里不是洁癖——CUDA Graph replay 要求同样的输入必须产出同样的 region 顺序,否则 attention 的 reduction 顺序会漂移。
3.5 一批小而重要的 kernel
除了三大件,还有几个容易被忽略但缺一不可的:
| kernel | 作用 | 备注 |
|---|---|---|
step5_qknorm_rope / _gated |
norm + RoPE,可顺带写 KV | rotary_width ∈ (64, 192) |
step5_csa_region |
单 region 的 R8 压缩 | 8 token 一个标量 max |
append_ring |
ring 追加与满 8 触发压缩 | 先读后写 |
step5_pack_decode_regions |
选择结果 → int64 [T,513] | 高低 32 位打包 |
step5_fp8_kv_dequant_pages |
FP8 KV 反量化整页 | prefill 前用 |
step5_fp8_kv_remap_pages |
反量化后的 address remap | 与上一条配对 |
fused_sigmoid_mul |
sigmoid(g) * x |
round_gate=True |
SiluClampAndMulOp |
clamp 版 SwiGLU | FP32 中间量 |
Step5RouterTopKOp |
352 选 8 + bias 选择 + renorm | 顺序敏感 |
step5_fp8_kv_* 那两条值得单独说一下:prefill 走 FP8 KV 时,union kernel 只吃 BF16,所以要先开一块 scratch 把用到的整页反量化(step5_fp8_kv_dequant_pages),再把 packed 里的物理地址映射到 scratch 上(step5_fp8_kv_remap_pages)。decode 则不用反量化——kernel 直接吃 E4M3 + per-token scale(kv_fp8=True 时 dtype 变成 Float8E4M3FN,多两个 k_scale / v_scale 参数)。
3.6 MoE 与通信侧
- MegaMoE:
forward_mega_moe_local_experts把 routing 结果和本地专家偏移交给deep_gemm.fp8_fp4_mega_moe,recipe(1,1,32)、activation="swiglu"、activation_clamp=swiglu_limit。要求 FP8 experts。_configure_mega_moe_deep_gemm_num_sms会预留一部分 SM 给通信,偶数 CTA。 - 边界融合:
Step5BoundaryFusions把 all-reduce + 残差 + RMSNorm 三件事合成一个 kernel,底层是CustomAllReduceV2。门槛很硬——capability == (10, 3)且拓扑必须是((4,4,1),"trtllm")或((8,8,8),"mnnvl"),TP4 时max_rows=32、TP8 时max_rows=4。跨机 MNNVL 场景的 workspace 也是单独申请的。 - deferred finalize:FlashInfer TRT-LLM 的 MoE 支持
forward_deferred_finalize,返回一个Step5DeferredMoE句柄;它的complete()把finalize_flashinfer_trtllm_deferred_output和 all-reduce 合成一步,交给层边界的残差/norm 流一起做,省掉一次独立的 reduce kernel 和一次显存往返。
4. SM90 与 Blackwell 的行为差异
4.1 一张图看清分叉
同一个 Python 前端,按 torch.cuda.get_device_capability() 分流到三套实现;绿色格只有 capability (10, 3) 才会走到。
判据在代码里只有三种写法:
1 | |
注意 没有 == (10, 0) 的分支。B200 和 B300 共享全部 Blackwell 通用路径,B300 只是多了若干 (10, 3) 的增强。所以"SM100 vs SM103"的差别不是两套 kernel,而是"同一套 kernel 加不加融合"。
4.2 SM103 专属的那些增强
逐条列一下 (10, 3) 才打开的东西,以及它们各自省了什么:
| 增强 | 位置 | 省掉什么 |
|---|---|---|
qkv_gate_weight 单 GEMM |
Step5Attention.__init__ |
一次 gate 投影 |
qkz_weight 打包 |
Step5Indexer.__init__ |
两次 indexer 投影 |
| Q→E4M3 融合 cast | step5_indexer_norm_rope |
一次独立量化 kernel |
| 0.5 缩放折进 Q | fold_indexer_scale |
打分时的一次乘 |
| DSA head gate epilogue | step5_sparse_decode_partials |
一次 elementwise |
use_allreduce_dp_gather |
TP8/attn DP2/EP8 组合 | 一次 gather |
fuse_shared_finalize |
TP8/EP8 或 TP4/EP1 | 一次 shared expert finalize |
Step5BoundaryFusions |
层边界 | allreduce+residual+norm 三次启动 |
dsa_overlap_max_rows = 256 |
alt stream 并行判据 | 更多行数能吃到双流 |
| MNNVL workspace | _get_comm() |
跨机 all-reduce 的额外拷贝 |
这些都不是"算法改进",纯粹是"在 B300 上能把几个 kernel 缝起来"。反过来说,B200 上跑出来的数值结果应该和 B300 一致,只是慢一点。
4.3 四套官方 recipe 的差异
SGLang cookbook 里 Step5 Preview 只对 B300 和 H200 做了签核,给了四套配置:
| 维度 | B300 低延迟 | B300 均衡 | B300 高吞吐 | H200 |
|---|---|---|---|---|
| 并行 | TP4 | TP4 | TP8 + attn DP2 + EP8 | TP8 + EP8 |
| attention | FA4 | FA4 | FA4 | FA3 |
| MoE | flashinfer_trtllm |
megamoe |
flashinfer_trtllm |
triton |
| KV cache | BF16 | BF16 | BF16 | BF16 |
| prefill graph | breakable | breakable | disabled(eager) |
— |
几条可以直接对上的因果:
- H200 只能用 TP8。FP8 权重约 650 GB,TP4 放不下(官方文档原话)。
- H200 配方用的是 Triton runner。
flashinfer_trtllm和 MegaMoE 都要求 Blackwell 的 MMA 形态;mega_moe.py里虽然另有 SM90 的独立实现run_sm90_mega_routed(is_sm90_fp8_mega_moe_available()),但 cookbook 把 MegaMoE 限定在 Blackwell。 - 高吞吐那套显式关了 prefill graph(
--cuda-graph-backend-prefill disabled),cookbook 说该 recipe 使用 eager prefill;同一段文档也提到 B300 TP8/EP8 + attn DP2 + MegaMoE + BF16 KV + MTP 这个组合是可以开 breakable 的。也就是说关 graph 是这一格签核配置的选择,不是硬限制。 --swa-full-tokens-ratio 0.03对应swa_tokens = int(full_tokens * ratio),也就是 SWA 池只留 FULL 池的 3%。这个数不是拍的,Step5PoolConfigurator里有下限:
1 | |
窗口 512、page 64,一个请求至少要 10 个 page 才能转起来;按 3% 的池子比例反算,FULL 池得够大才不会把 SWA 池压到下限以下。
4.4 为什么 FP8 KV 只在 Blackwell,而且只在 full 层
Step5TokenToKVPool 有两条实现:
Step5Fp8FullKVPool:K/V 存 E4M3,另存一份 FP32 的 per-token scale;- 默认 BF16 路径。
FP8 只作用于 full-attention(DSA)层:SWA 层的窗口只有 512 个 token,省不了多少显存,却要多付量化/反量化的开销;而 DSA 层要读 513 个 region × 64 token,KV 容量是真正的瓶颈。
至于为什么 SM90 配方不开 FP8:cookbook 的 disableReason 写得很直接——“The SM90 sparse decode kernel only supports BF16 KV cache.” 有意思的是 compile_decode_sm90 其实保留了 kv_fp8 参数分支,只是官方没有把这条路径纳入签核矩阵。工程上这属于"代码留了口子,配方没开"。
4.5 性能
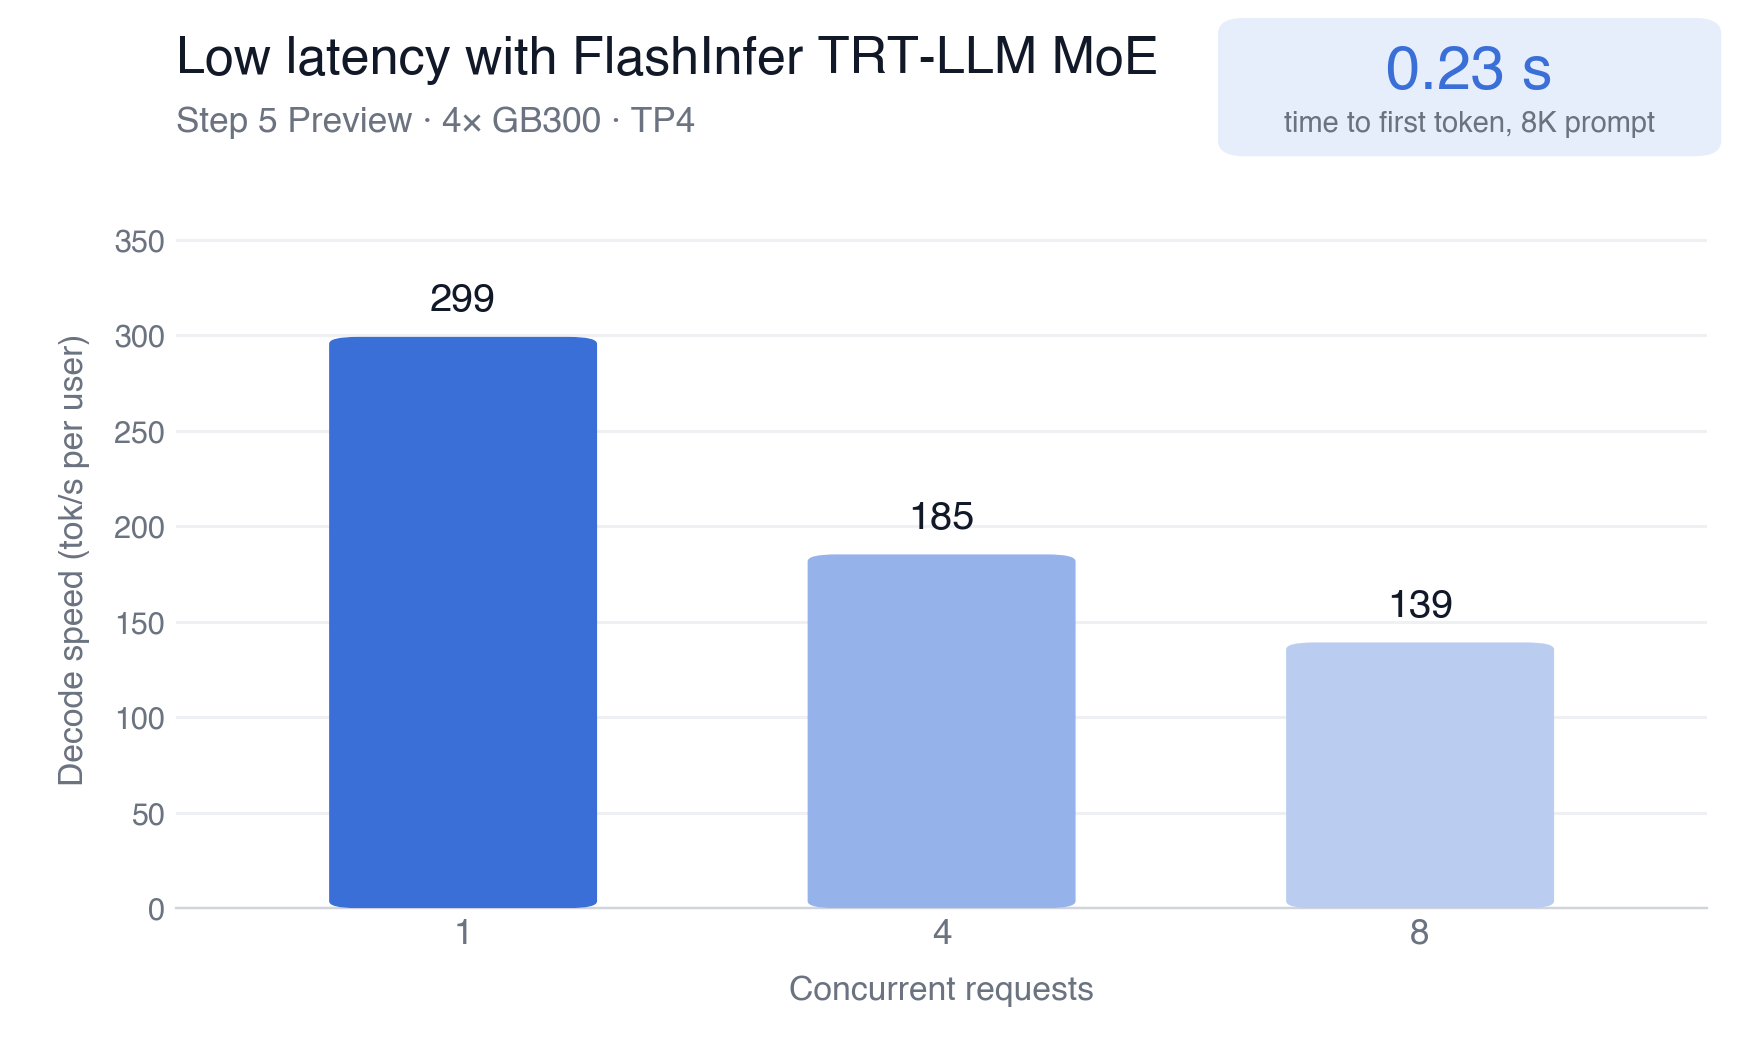
4×GB300(TP4),1–8 并发下的单用户 decode 速度;TTFT 是单请求 8K prompt。
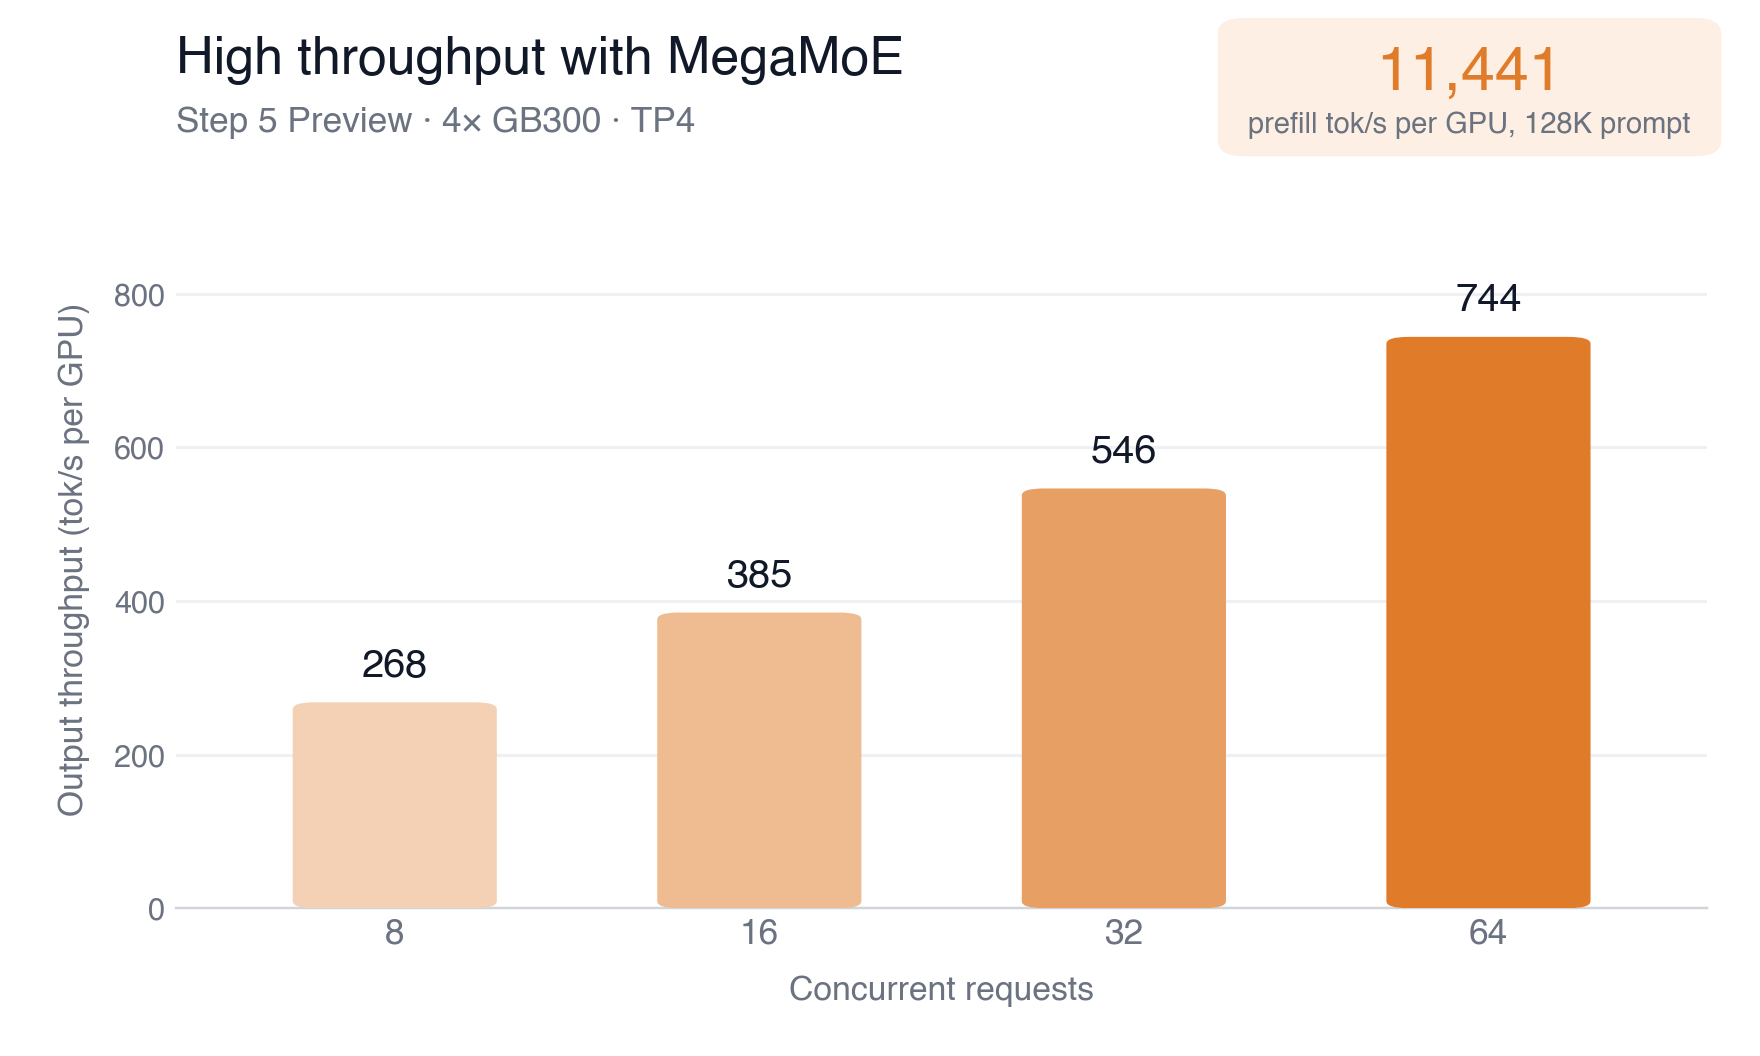
4×GB300(TP4),8–64 并发下的每 GPU 输出吞吐;prefill 吞吐是单个 128K prompt 的平均值。
两组数字放在一起看:
| 场景 | 配置 | 结果 |
|---|---|---|
| 单请求 decode | FlashInfer TRT-LLM MoE,4×GB300 | 约 299 tok/s |
| 64 并发 decode | MegaMoE,4×GB300 | 约 740 tok/s/GPU |
| 128K prefill | MegaMoE,4×GB300 | 约 11,440 tok/s/GPU |
三个数都是 FP8 routed experts(最后三层 MoE 仍 BF16)、BF16 KV、MTP 接受长度 2.85、约 8K 输入、768–1280 输出、无 prefix cache 命中。MTP 接受长度 2.85 意味着 3 层 draft 平均能带出 2.85 个 token——对 decode 来说这几乎是 3 倍的吞吐放大,也就解释了为什么 299 tok/s 这个单请求数字看起来比同规模 dense 模型高。
5. 几个观察
读完整套实现,有几件事值得记下来:
第一,形状就是 ABI。 Step5Config 那个 11 元组校验、kernel 里的 HEADS = 8 / DIM = 192 / PAGE_SIZE = 16、packed int64 [T, 513]、lse [4, 16]——这些东西一旦写进 kernel,前端就再也没有"灵活一点"的空间。好处是问题在加载期就暴露,坏处是任何模型微调都得同步改 kernel。
第二,稀疏注意力的成本被拆到了三个地方。 indexer(每 8 个 token 一次 256 维投影)、scoring(每个 query 对 ceil(pos/8) 个 region 打分)、attention(只算 513 个 region)。三者的相对开销随上下文长度变化:短上下文时 indexer 占大头,长上下文时 scoring 和 attention 占大头。selection_tile_rows 的 512 MiB 预算就是为第三段准备的。
第三,融合全部发生在"边界"上。 qk-norm + KV store、QKV + gate、gate + attention epilogue、allreduce + residual + norm、R8 压缩 + ring 追加。没有一个是"把两个大 GEMM 合成一个",全都是省 kernel 启动和中间张量的落地——这也是 decode 阶段最有价值的那类优化。
第四,prefill 和 decode 的稀疏策略无法统一。 prefill 有足够的 query 行可以摊销 K/V 加载,所以求并集;decode 只有 4 行 query,求并集没有意义,只能切分历史。两套 kernel 各自优化自己的瓶颈,这大概是长上下文模型推理的常态。
参考
- SGLang 官方博客:Step 5 Preview: Day-0 Inference and RL Support with SGLang and Miles
- Cookbook:Step-5-Preview
- FlashInfer patch 说明:docker/patches/step5/README.md
- StepFun 贡献的 union kernel:cute/sm100_union/