flash attention V2 代码走读
flash attention V2 代码走读
本篇博客参考最新的 flash attention V2 的代码发布版本 v2.8.3,旨在对 flash attention V2 中前向推理的代码实现部分进行详细的解释,但在阅读本文前,必须有如下知识储备:
- 了解 flash attention V2 算法设计,建议阅读笔者之前发布的文章:flash attention 进化史中 flash attention V2 的部分
- 了解 Cutlass Cute,因为算法实现使用了大量 Cutlass Cute 的抽象,推荐阅读 reed大佬的 cute系列文章
- 其他关于 LLM 使用的算法和实现,建议阅读进击的这篇知乎博客以补充一些基础知识
本文除了描述 Tri-Dao 等人对 flash attention V2 的实现细节外,还添加了对不少笔者自己的理解,包括 Cutlass Cute 使用、流水线设计、并行化思路的理解,如有纰漏,请各位读者指正。
flash attention 代码树
flash-attention v2.8.2 包含了 AMD、flash attention V2、V3 等核心代码实现,代码实现极为庞大繁杂,本篇博客重点讨论 flash attention V2 的 C++ 代码实现情况,为了能让大家快速熟悉项目,特制作了一份关于 v2.8.3 的文件树:
1 | |
下面笔者开始领大家阅读源代码。但请注意,为了使博客不被冗长的代码占据空间影响观感,笔者只会在必要时截取少量修改后的代码以方便讲解。
伪代码改造
我们先站在高处俯瞰整个 flash attention v2 代码实现,再层层拨开实现细节,好让大家不迷失在语法和细节的海洋里。
为更好表述,这里先展示一下 flash attention V2 涉及到的关键 tensor 的 shape 情况,并顺便做命名规范:
| Tensor | Shape |
|---|---|
| [batch_size, q_seqlen, q_numheads, head_dim] | |
| [batch_size, kv_seqlen, kv_numheads, head_dim] | |
| [batch_size, kv_seqlen, kv_numheads, head_dim] | |
| [batch_size, q_seqlen, q_numheads, head_dim] |
老规矩,在正式开始前,我们来回顾一下 flash attention V2 的伪代码实现:
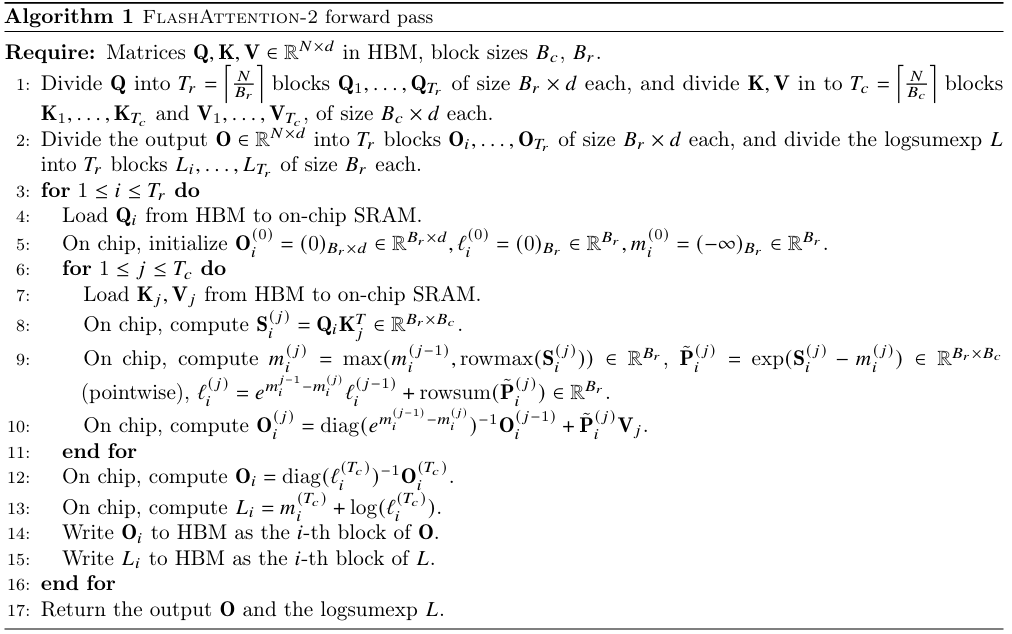
flash attention V2 算法步骤:
- 将 都分块,输出 也会被分块。
- 开始两层循环,其中外循环是 上 N 维度的循环,内循环是 上 N 维度的循环。
- 在外循环开始时,程序会从 HBM 中 load 一个小块 ,最后计算出对应的 结果写回。
- 然后再看内循环,它会不断地 load ,再计算 和 ,完成对 的累加。
- 最后,内循环结束,写回 HBM,外循环侧继续 load 下一个块的
论文给出的 flash attention V2 forward 算法很清晰直观,但若要直接根据上面伪代码来对应到真实代码恐怕还不行,因为伪代码中缺少了很多细节和应该描述的并行性,而这点容易被很多人有意无意地忽视,往往会造成伪代码一看就懂,但 CUDA 代码一看就懵的情况。
如何并行?
flash attention V2 对 Multi-Heads Attention(MHA) 和 Group-Query Attention(GQA) 都支持,从下图可直观看到,MHA 很容易在 batch size 和 num heads 维度上并行,因为这两个维度之间没有数据依赖:

在计算 prefill 时,一般有: q_seqlen == kv_seqlen,从上面的伪代码可知,q_seqlen 和 kv_seqlen 都会被分块然后被并行计算;而在 decode 时,q_seqlen == 1,若仍按原算法执行,就少了一个并行维度,可能会浪费算力。
好在目前主流模型为降低 KV Cache 容量,都已不采取 MHA ,而是采取 GQA :它将多个 绑为一组,共同映射到一个 tensor,那么这一组 中计算也可以并行。于是在算法实现中,GQA 的 decode 阶段,group 数会被折算为 q 方向的 seq 长度,即 q_seqlen == q_numheads/kv_numheads,这样就可以增大 Q 方向的并行度。
之后我们还会看到,为提高长文本下计算性能,flash attention V2 参考 Flash Decoding 的思想,将 kv seq len 维度进一步切分(称之为 splitK)。
上面伪代码处理 的分块相同,将 =seqlen 维度分为大小为 kBlockM 的总数为 num_m_block 块;而 的分块相同,它将 分为大小为 kBlockN 的总数为 num_n_block 块。flash attention V2 在 flash_api.cpp::set_params_splitkv 处计算了这些分块大小:
1 | |
请读者仔细观察一下 head dim 大小和 kBlockM kBlockN 大小的关系!你会发现如果 HeadDim 一大,kBlockN 就要小,这是因为 kBlockN * HeadDim 积 与占用 SRAM 面积成正比例,为了保证代码性能的通用性,需要确保任何case下占用的 SRAM 大小都差不多,所以设计了上面这个判断流程。
再关注一下 CUDA blocks 的划分方法,block 数量上
-
prefill 阶段,固定划分方式为 :
dim3 grid(num_m_block, params.b, params.h); -
decode 阶段:
- ngroups > 1 GQA:
q_seqlen=ngroupsgrid(num_m_block,bs,kv_heads) - ngroups == 1 MHA:
q_seqlen=1grid(num_m_block,bs,q_heads)
- ngroups > 1 GQA:
-
num_splits > 1 (Flash Decoding 技术)grid(
num_m_block,num_splits,bs * q/kv_heads)
Block 大小:固定为 128 threads 4 Warps
参考 flash_fwd_launch_template.h 代码:
1 | |
伪代码修订版
于是,笔者结合了代码中的变量名以及实际在 GPU 上并行的部分,将上面的伪代码改造了一下:
1 | |
变量解释:
- batch_size,批处理大小:
params.b - kv_numheads,GQA 架构下的 kv heads 数:
params.h - q_seqlen 分块后的个数:
num_m_block - kv_seqlen 分块后的个数:
num_n_block - Q:
sQ表示 SRAM 上的 Q 分块,gQ表示 HBM 上的分块,依此类推 K,V,O,lse
上面的伪代码中,从第 8 行开始就是一个 TB 完成的任务了,它会处理伪代码中的 inner loop,在图中就是对应 q 分块的一个小块,对应 kv 的一行。下图中, 的分块相同,将 =seqlen 维度分为大小为 kBlockM 的总数为 num_m_block 块;而 的分块相同,它将 分为大小为 kBlockN 的总数为 num_n_block 块。
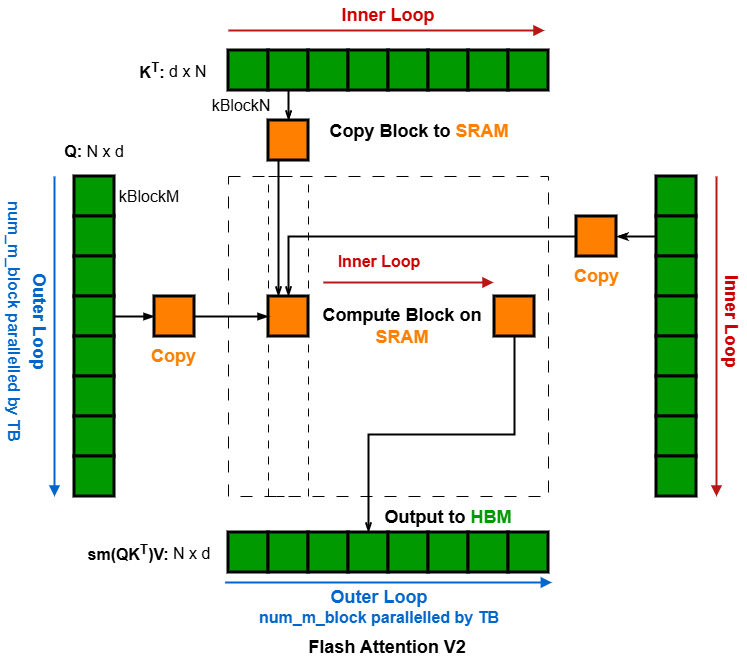
flash attention V2 的内循环实现是本博客关注的重点,它由一个 thread block 完成,笔者将内循环伪代码逻辑写了出来,方便大家理解:
1 | |
结合上图和伪代码,我们来整体过一下一个 thread block 在计算 flash attention V2 时的行为:
- 从图的左边开始,首先要将一个小块的 加载到 SRAM 上,对应到伪代码,就是第二行的
async_load(q_i),async_load(k_0)也提前发出以实现最大程度的计算与访存 overlap 和fence()则是用于等待确保加载已完成 - 然后开始内循环,图的上侧显示,程序从 HBM 中 load ,在拿到了需要的 后,还需要立刻发出
async_load(v_j),这也是为了实现最大程度的计算与访存 overlap - 图中间显示,计算
q_i@k_j.T和softmax(s_ij) - 图的右侧显示,程序从 HBM 中 load ,这里需等待确认已完成 加载
- 图下侧显示,计算好
s_ij@v_j+1,累加到o_iSRAM 中,待内循环完成后,再写入到 HBM 上
代码实现
伪代码可以帮助大家对 flash attention V2 算法和 compute_attn_1rowblock 实现有个大概的理解和印象,那么我们接着再深入看看真实代码实现。
compute_attn_1rowblock
1. 参数及输入变量介绍
首先,我们来看一下 flash attention V2 从 python 到 C++ 的调用路径是怎么样的:
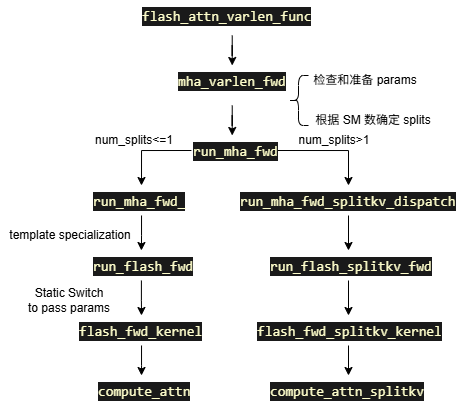
结合上图的调用栈情况,我们来重点关注 C++ 层面的 attention 相关的参数含义,以便理解后续代码实现。
先来理解这个宏定义的flash_fwd_splitkv_kernel的 template name 和几个输入变量:
1 | |
- 第一个参数
Flash_fwd_params params的类型定义,包括了很多 attention 计算中重要的参数设置,params的值在flash_api.cpp::mha_varlen_fwd内就已经配置好,一步步传参到flash_fwd_splitkv_kernel,这里写出几个比较重要且用得到的变量:
struct Flash_fwd_params : public Qkv_params:
int * cu_seqlens_q:仅 varlen 中生效,存放了每个 q seq 的长度情况,但存放方式是使用前缀和的方式存放,例如 [0, 248, 249, 250] 就表示第一个 q 长度 248,后续两个 q 长度都为 1;cu_seqlens_k同理void *q_ptr:q 张量的指针,- 在
mha_fwd函数中维度是(batch_size, seqlen_q, num_heads, round_multiple(head_size, 8)); - 在
mha_varlen_fwd函数中,q 张量的维度是(total_q, num_heads, head_size),因为变长的 seq 被压缩到了一个维度total_q之中。
- 在
d_roundedd分别指 head_dim 对齐后和本身的大小block_table和block_table_batch_stride分别指 attention 计算是需要的 kv cache block table 和对应的步长。oaccum_ptro_ptr分别指 kv split 时要累加后的 o 张量指针和 kv split 不打开时不累加的 o 张量指针int q_batch_strideq 张量在 batch 维度的步长int q_row_strideq 张量行方向步长int q_head_strideq 张量在 num heads 的步长- 上述变量针对 k,v 时同理
- 关注 template name
Kernel_traits:Flash_fwd_kernel_traits使用了 C++ 中 traits 编程技巧(该技巧适用于在 template function 间传输静态变量),将编译期的静态变量值传入:
主要包括了切片的MN大小和处理的 Warps 个数(思考,为什么不在 params 内写明而要写在 Kernel_traits 内?运行时变量和编译时变量的取舍,性能与编译速度)
1 | |
- 再看 template 后面跟着的几个变量:
-
Is_causal是否需要应用 causal_mask, 与Is_local互斥,计算公式 i+k-q- 若 causal=True, causal mask 对齐右下角的注意力矩阵:
例如, 若seqlen_q = 2且seqlen_k = 5, causal mask (1 = keep, 0 = masked out):
1 1 1 1 0
1 1 1 1 1 - 若
seqlen_q = 5且seqlen_k = 2,causal mask:
0 0
0 0
0 0
1 0
1 1
- 若 causal=True, causal mask 对齐右下角的注意力矩阵:
-
Is_local- 是否应用滑动窗口局部注意力(sliding window local attention), 只有在
params.window_size_left >= 0 || params.window_size_right >= 0且!Is_causal成立。-1,-1 时则不使用 sliding attention。 - 具体实现原理可以参考这篇文章
- query i 对应的 key 计算范围
[i + seqlen_k - seqlen_q - window_size[0], i + seqlen_k - seqlen_q + window_size[1]]这点可以从下面第 2 小节的代码中确认。

- 是否应用滑动窗口局部注意力(sliding window local attention), 只有在
-
Has_alibi- 是否加上 alibi 斜率偏置,
params.alibi_slopes_ptr != nullptr时成立。原理参考这篇博客 (-alibi_slope * |i + seqlen_k - seqlen_q - j|)会被加到 query i 和 key j 对应的 attention score 中。
- 是否加上 alibi 斜率偏置,
-
Is_even_MN- 定长条件下,用
kBlockM和kBlockN对seqlen_q和seqlen_k进行分块后是否能被整除,该条件涉及到 attention 计算时一些边界情况的处理 IsEvenMNConst成立条件:params.seqlen_k % Kernel_traits::kBlockN == 0 && params.seqlen_q % Kernel_traits::kBlockM == 0,- 但实际实现中,该条件成立需要满足
IsEvenMNConst && !Append_KV && IsEvenKConst && !Is_local && !Has_alibi && Kernel_traits::kHeadDim <= 128,这是为了减少一些不太常用的 templates,否则编译时间过长,二进制文件过大
- 定长条件下,用
-
Is_even_K
headDim 是否是32的倍数,模板支持了 headDim 从 32 到 256 的倍数,params.d == Kernel_traits::kHeadDim -
Is_Softcap- 对注意力分数的非线性变换技术,使用 tanh 函数对注意力 logits 做软限制,成立条件
params.softcap > 0.0
- 对注意力分数的非线性变换技术,使用 tanh 函数对注意力 logits 做软限制,成立条件
-
Split- 是否对 kv 方向维度做切分,成立条件
num_splits > 1 flash_fwd_splitkv_kernel独有的
- 是否对 kv 方向维度做切分,成立条件
-
Append_KV- 在增加新的一段上下文做注意力计算时使用的 kv new matrices ,成立条件
params.knew_ptr != nullptr flash_fwd_splitkv_kernel独有的
- 在增加新的一段上下文做注意力计算时使用的 kv new matrices ,成立条件
理解了这些输入变量和 template 后,再来看一下 run_flash_splitkv_fwd 的整个实现:
- 代码使用了大量宏定义来完成对编译期变量的赋值,
flash_fwd_splitkv_kernel会被先调用,计算完成后,针对在 kv 方向切分后,对计算得到若干个分块的 O 和 LSE 做合并,使用的是flash_fwd_splitkv_combine_kernel函数 - 请关注一下 CUDA 程序的 block 数量,这直接关系到下面的 kernel 函数如何确定 block 数量和 id:
- X 维度
num_m_block,指并行 query 被切分的维度 - Y 维度
params.num_splits > 1 ? params.num_splits : params.b,若存在 KV 切分(大部分场景),并行num_splits,若不存在,则并行 batch size 维度 - Z 维度
params.num_splits > 1 ? params.b * params.h : params.h,并行 batch size 和 head size 维度
- X 维度
1 | |
作为呼应,我将 compute_attn_splitkv 的最开始关于变量声明和赋值的部分放在这里。注意,flash_fwd_splitkv_kernel 就是 compute_attn_splitkv 函数的一个套壳而已,区别不大:
- gridDim.x 维度的并行度一直是 query m blocks,因此
m_block = blockIdx.x,一个 block.x 对应一个 block 的 query - Split > 1
- gridDim.y 维度对应 num_splits 并行度,因此
n_split_idx = blockIdx.y一个 block.y 代表一个 kv splits - gridDim.z 维度对应 batch size 和 num heads 两个并行度乘积,因此
bidb = blockIdx.z / params.h和bidh = blockIdx.z - bidb * params.h表明了 batch size 在外维重复,heads 在内维重复。
- gridDim.y 维度对应 num_splits 并行度,因此
- Split == 1 类似,不再赘述
1 | |
2. early exit 处理
现在我们正式开始对 compute_attn_1rowblock_splitkv 的走读,跳过一些变量的定义后,我们来到了第一个小板块:early exit 处理。
在真实场景中,很多 attention block 分块是不需要处理的,因此在函数的最开始,需要跳过那些因为 window attention、causal mask 等场景下不需要计算的 block 和情况。
比如,分到的 m_block 块已经超过了实际 seqlen_q 的长度,那就没必要计算,直接 return:
1 | |
接着需要计算 kv 方向的参与计算的 block id 号,为了保证序号正确,Tri Dao 通过 n_block_min 和 n_block_max 来确定 K 方向上需要计算的最大块号和最小块号:
1 | |
因为 n_blocks_per_split 实际表示了每个 kv splits 含有多少 blocks,所以 n_block_min 和 n_block_max 一般情况下就是 [n_split_idx * n_blocks_per_split, (n_split_idx + 1) * n_blocks_per_split],也就是通过 splits id 来确定。非 sliding windows local attention 的情况比较少见,不再详细介绍,相信看代码也能明白。
确定好 n_block_min 和 n_block_max,我们就可以判断哪些场景是不需要处理的了:
Part I.
1 | |
row_offset_o 计算得到了当前 thread block 对应的行偏移量,详细参考 blockinfo 实现。考虑到 grid 维度为 (num_m_block, params.b, params.h) 和对应 blockIdx 为 (m_block, bidb, bidh),因此有 row_offset_oaccum 和 row_offset_lseaccum 的计算偏移公式。
获得准确的偏移量后,gOaccum 和 gLSEaccum 使用 cutlass3 API 构建对应分块的 tensor。
Part II.
下面的代码使用了更多 cutlass 相关的操作。它就是想让 gOaccum 做清零,但因为使用了 cutlass3 tiled copy,所以比较代码显得复杂,具体解释可见copy tile。 tOrOaccum 清零后,最终用 FLASH_NAMESPACE::copy 移动到目标 gOaccum 中,实现对 gOaccum 的清零。
1 | |
3. 张量数据预处理
Part I.
flash attention 2 需要用 cutlass cute 对张量进行预处理。要注意这里的技巧(注释里写明),就是后续实现中会逆序对 block 迭代循环,所以初始化时直接偏移到了最后一个 block。之所以逆序遍历所有 block,是因为从全局内存读取 K 和 V 时,仅最后一个块需要进行掩码处理。此外,采用逆序遍历的方式或许还能节省一个寄存器(我们只需存储 n_block,而无需同时存储 n_block 和 n_block_max)。该部分获得了最后一个块的 row_offset_k 和 row_offset_v,使用了 block_info.h 中的 k_offset 函数。
需要注意到,若 block_table 为 null,那么使用 k_offset 方式正常计算偏移量,而若有 block_table,则会使用 block_table 内存放的 kv tensor,
block_table[block_table_idx] * params.k_batch_stride计算 batch offsetblock_table_offset * params.k_row_stride计算 token(row)层面 offset(bidh / params.h_h_k_ratio) * params.k_head_stride因为 kv heads 通常少于 q heads,所以 head offset 如此计算。
1 | |
Part II.
使用 Cutlass cute 组装 tensor。简单介绍一下这里的 Tensor 命名规范。gQ, gK, gV 就是指全局内存上的 QKV,sQ, sK, sV 是 shared memory 上 QKV,tQgQ 表示 tQ 这个 tile(严格来说是 gmem_thr_copy_QKV 这个 ThrCopy)应用到 gQ 上时,返回的 partition 后的 Tensor。tSrQ 则是用 tS 这个 tile(严格说是 tiled_mma)应用到 sQ 上后得到在寄存器上的 tensor。
mQ该 tensor 指向一整个 seq_len 的 Q 张量,包括了所有的注意力头,因此有三个维度:(actual_seqlen_q, params.h, params.d)gQ从mQ上根据bidh索引得到的某一个 head 的 Q 张量,可理解为 Flash Attention 分块计算图中一整列绿色 Q 块。gK和gV就是 Flash Attention 分块计算图中表示的 K 和 V 的整行/列绿色块。sQ表示从gQ装载到 shared memory 的一小块 Q 块;sK表示从gK装载到 shared memory 的一小块。
1 | |
1 | |
4.数据拷贝
5.带mask的主体计算
6.不带mask的主体计算
7.结果写入全局内存
其他代码实现走读
cutlass 相关
copy tile
本小节参考 reed 大佬的 cute 之 copy 抽象。
Cutlass cute 提供了对数据搬运的数据结构抽象,主要包括 CopyOperation、Copy_Traits、Copy_Atom、TiledCopy、ThrCopy 和拷贝函数 cute::copy。这些结构和函数共同完成对GPU各个层级存储之上的数据进行搬运的抽象和实现,从底到高介绍:
- CopyOperation 提供了指令级的数据搬运的封装,NVidia 在不同的硬件架构、不同的存储层次之间数据搬运提供了不同的指令,如前文提到的 ldmatrix 和 LDS 等,还有针对Ampere架构的cp.async等,我们在使用时只需要根据我们的硬件支持的指令情况和需要搬运的内存层次来选择已经提供的Operation即可;
- Copy_Traits 提供了 CopyOperation 类型没有提供,但是其使用者 Copy_Atom 却需要的起到桥梁作用的信息;
- Copy_Atom 提供了指令级别不可分割的数据搬运的拷贝能力;
- TiledCopy 是对 Copy_Atom 的能力的封装,通过增加执行单元的个数(增加执行线程)或者重复做多次的拷贝实现对 Copy_Atom 的重复;
- TildCopy 提供的是逻辑上的拷贝的概念,在具体的 kernel 执行之时,为了复合CUDA的编程范式,需要写成线程级别的指令,ThrCopy 可以实现将大块的数据根据 TiledCopy 所描述的划分规则,通过提供当前线程的线程号 threadIdx.x 对大块的 Tensor 进行划分,得到当前线程为了完成 D = S 拷贝所需要该线程做的任务;
- cute::copy 在 ThrCopy 提供了当前线程的任务之后,便可以通过 copy 函数触发具体的数据搬运指令。
下图展示了 Cute copy 建立的生态软件抽象,首先在硬件之上提供了指令抽象 CopyOperation,再往上形成 S->D 的拷贝逻辑抽象,包含拷贝原子能力 Copy_Atom和对 Atom 重复后得到的 TiledCopy 能力,再逻辑之上针对具体的线程划分出具体的线程级的任务,通过 cute::copy 函数触发相应的拷贝任务,让所有线程共同完成 Tensor到 Tensor 的拷贝。
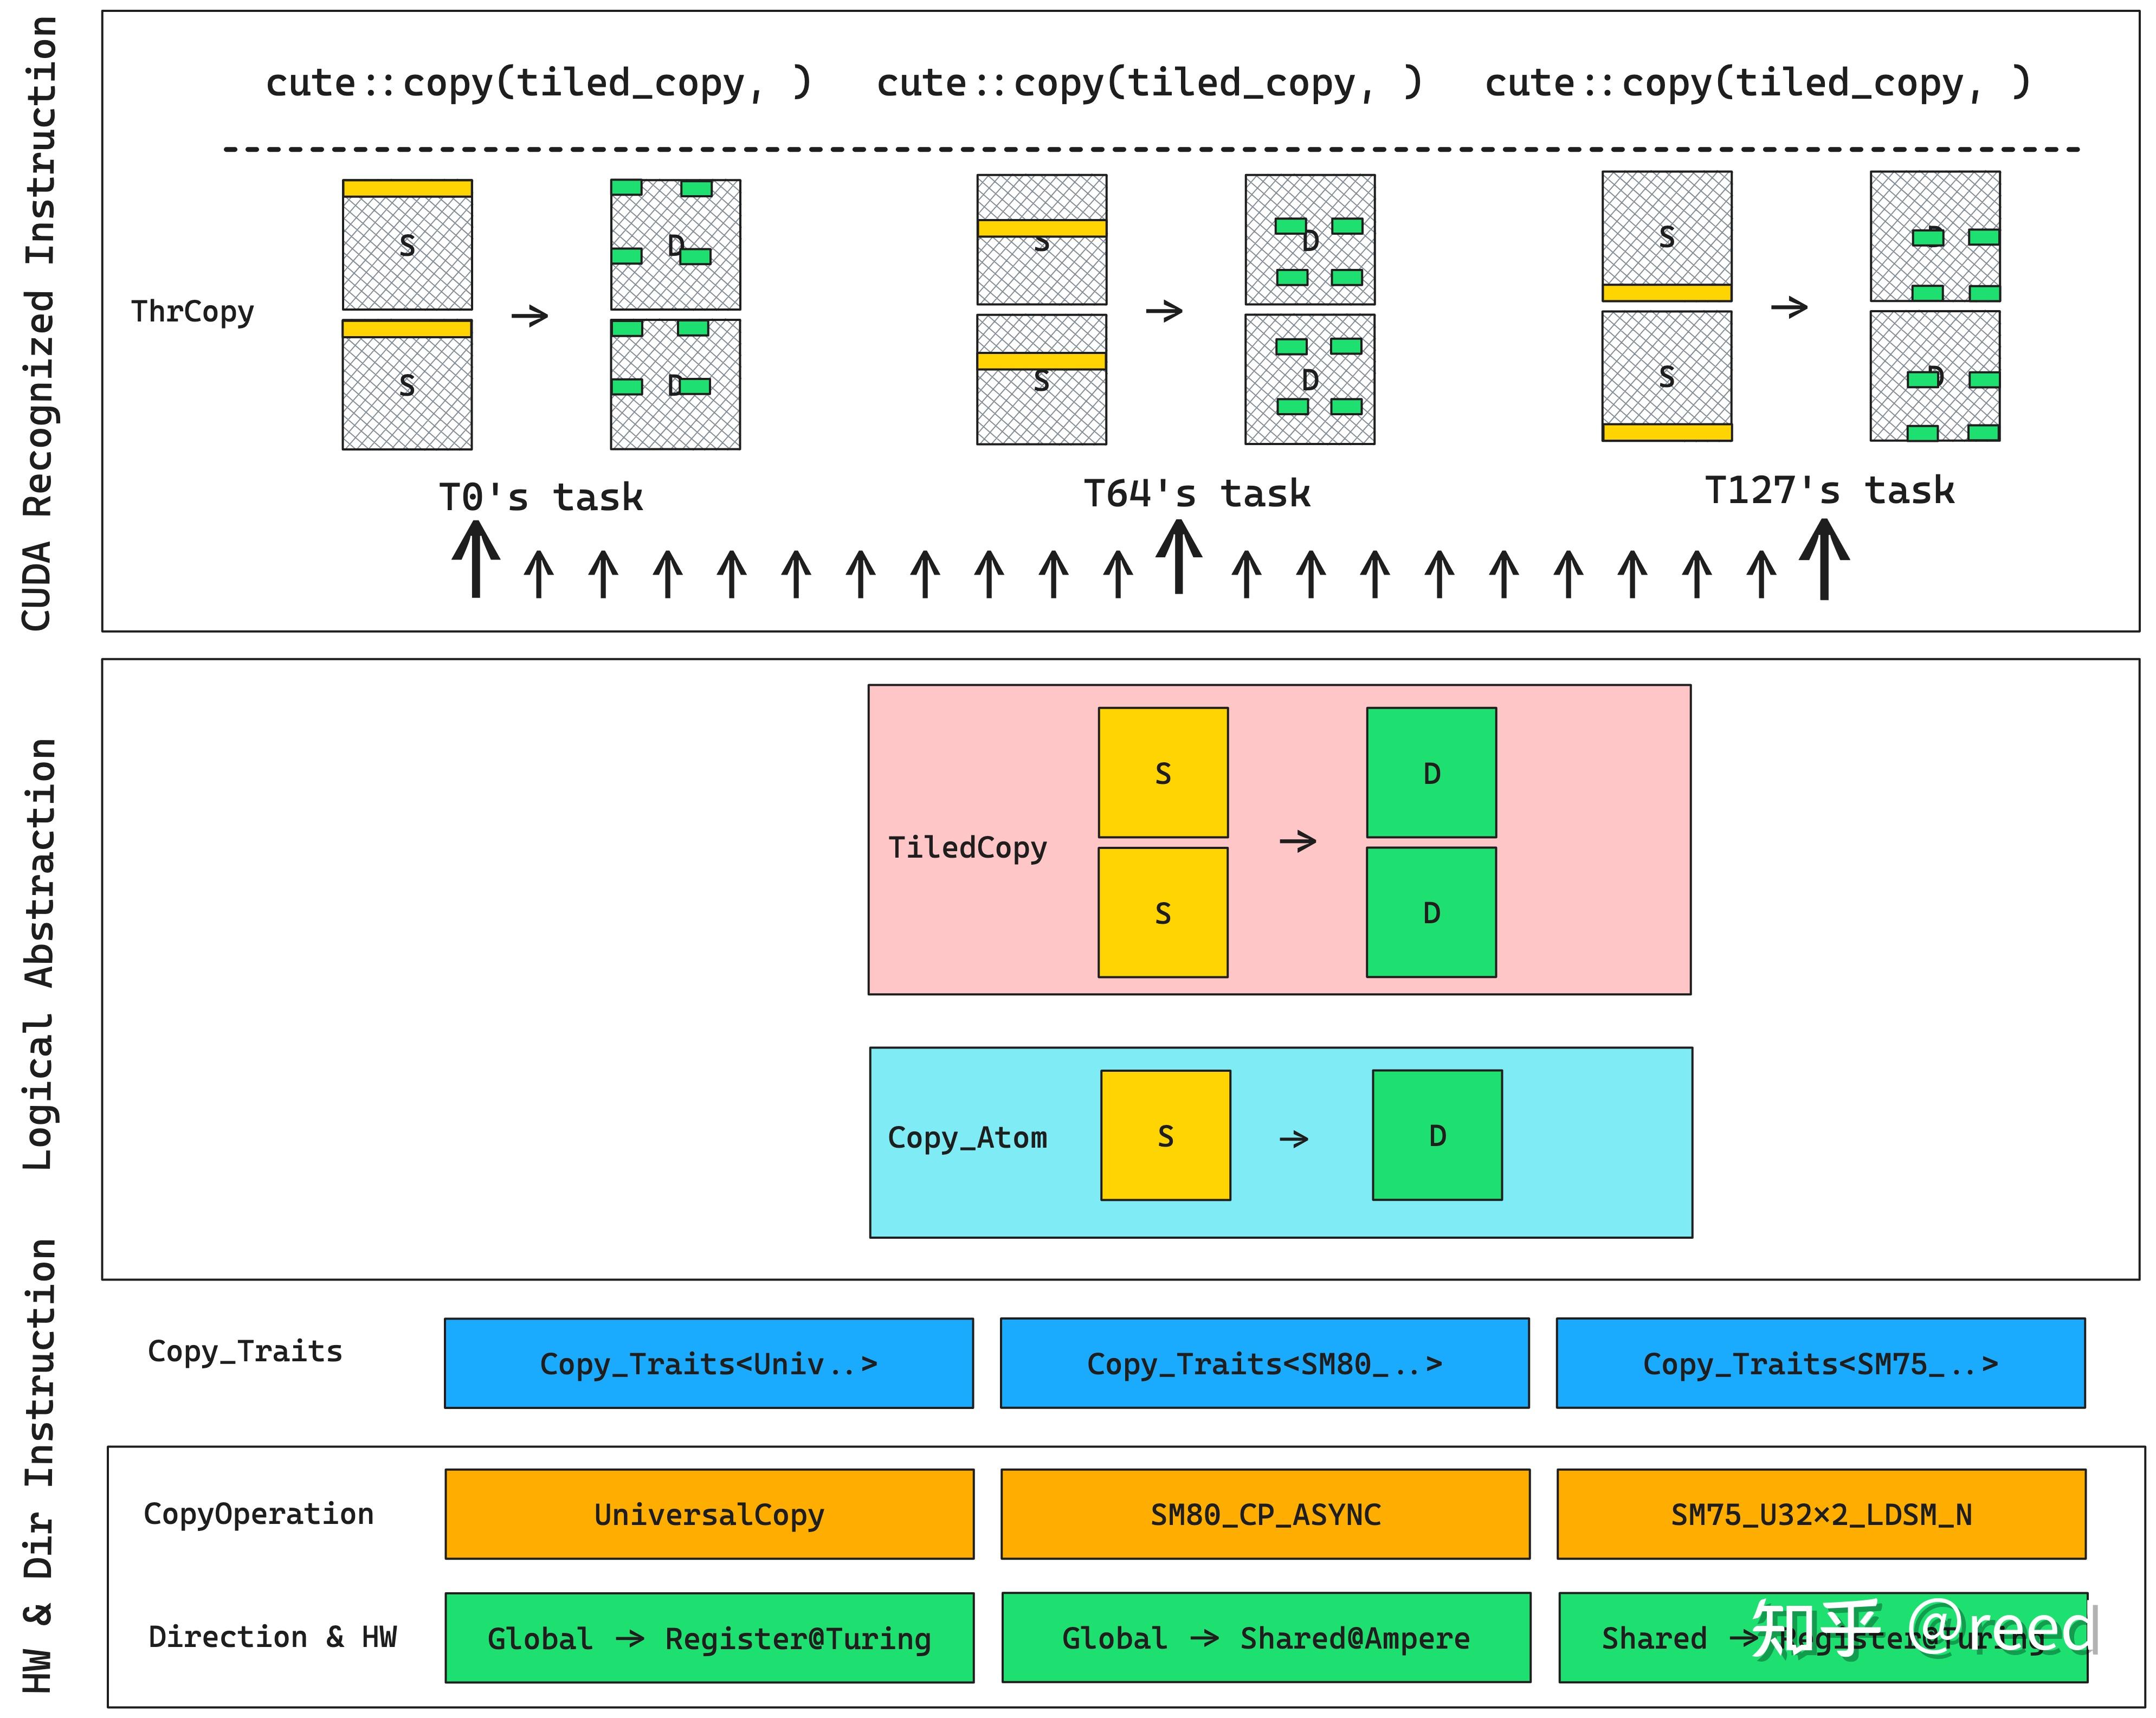
让我们就着下面的代码来理解 Cutlass Copy。上图中,最底层封装了硬件提供的指令级 CopyOperation 封装在 Cutlass Cute 内。然后 Copy_Traits 对应到代码中(因为它是针对 o 张量的 copy),就是 DefaultCopy(在 cutlass 3.6.0 上为 AutoVectorizingCopyWithAssumedAlignment<128>)。
这里插一句,如果是针对 QKV 张量的 copy,那么我们希望异步完成并使用 CACHEGLOBAL,于是使用 SM80_CP_ASYNC_CACHEGLOBAL 为 CopyOperation,那么 Copy_Traits 就写为:
1 | |
不难发现,一次内存 transaction load 默认就是 128 bits,因此 kGmemElemsPerLoad 就是用 128 bits 来计算一次内存 transaction 会装载多少个计算元素(element)。
然后,就是使用 Copy_Traits 和 CopyOperation 组成 CopyAtom,Copy_Atom<AutoVectorizingCopyWithAssumedAlignment<128>, Element>{},其实就是加了个要 copy 的元素类型。
再然后,CopyAtom 处理的元素还是太少(只有 128bits),因此要将 Copy_Atom 进行重复得到更大的块的拷贝能力,对 Atom 的重复可以通过 Layout 来提供,这里的 GmemLayoutAtom 表示要在列方向上提供 kGmemThreadsPerRow 个线程,在行方向上提供 kNThreads / kGmemThreadsPerRow 个线程,组成一个大的 TiledCopy。而 Layout<Shape<_1, _8>>{} 表示线程要重复 8 次做 copy。
那么我们用下面的数字来计算一下,一次 TileCopy 可以搬移多少数据:若为 bfloat16 数据,那么行方向上有 16 个线程,列有 8 个线程,而列方向上线程会重复 8 次做 copy,一次 Copy Atom 会移动 8 个 bfloat16 元素,于是一个 TiledCopy 搬移了 16 x 512 个元素。
1 | |
然后就是 ThrCopy 和 copy 函数,TiledCopy 提供的核心函数 get_thread_slice 可以实现将逻辑 Tensor 的拷贝能力划分给具体的每个线程,返回 ThrCopy 对象 gmem_thr_copy_Oaccum。ThrCopy 对象的核心函数为 partition_S/D 和retile_S/D,其中 S 和 D 分别表示 source 和 destination,partition 表示对一个大的逻辑 Tensor 进行划分得到当前线程的拷贝所需要的源 Tensor 和目标 Tensor, 而 retile 系列的函数表示其输入的数据已经是当前的线程的私有的数据了,但是其可能不满足拷贝所要求的形状,需要将其变换到拷贝所支持的形状。
cute::copy 函数是拷贝的实际执行函数,调用该函数会触发线程级别的拷贝的发生,完成线程指令的执行,实现 src 到 dst 到数据拷贝指令。flash attention 中 FLASH_NAMESPACE::copy 对 cute::copy 做了封装,针对多维的 tensor 重复调用 cute::copy 做数据搬移。
1 | |
async load 与 fence
fence(): cp_async_fence() {
asm volatile(“cp.async.commit_group;\n”;;)
}
kernel traits
C++ template 编程中有一种非常 tricky 的编程技术,名叫 traits(萃取)。它是一种编译时技术,可以用于在编译期获得操作类型信息,从而让程序在编译期做出决策。该技术在泛型编程(generic programming)中被广泛使用。
上述这段话是我在网上搜 traits 时经常看到的对 traits 的介绍,但我觉得这些介绍非常难以理解,我觉得读者不妨将 traits 理解为一种模板类抽象的输入,但这个输入不只是传统的变量,还有数据类型。
借用 reed 大佬在 cute 之 MMA 抽象 中所描述的话:
traits 是函数抽象,这个函数接受的输入是数据类型而不是传统的变量或对象,同时这个函数可以返回多个属性。对于使用者而言,这些信息是使用者所需要的,但是有不是原始的类型所必须的。也就是说有些信息不属于类型,但是这部分信息对于调用者却需要,这样我们引入 traits,其承接类型到该类型使用者之间的桥梁作用
比如,在 flash_fwd_launch_template.h 和 kernel_traits.h 中,有如下实现:
1 | |
Flash_fwd_kernel_traits 之所以通过这种方式将 HeadDim,kBlockM,kBlockN 等数值传入,也是为了满足使用 cutlass cute 的编程方式。
static switch
utils
BlockInfo
q_offset 实现:
flash attention 的输入 tensor 是多维度的:(batch_size, seq_len, num_heads, head_dim),考虑到 tensor 在 seq_len 维度分块被切分,称呼被切分后每块 seq_len 为 row,即为分块图中的一行;再假设 flash attention 的输入 tensor 步长为 (batch_stride, row_stride, head_stride, 1)。
如何并行部分提到,batch_size 和 num_heads 这两个维度天然可以并行,但一个在最高维度并行,另一个则是在 seq_len 后并行,对应到代码中,bidb 指示了 batch 层面的 id,bidh 指示了 num heads 层面的 id,于是 bidb 维度要先计算偏移,而 bidh 维度要在 row 之后计算偏移。但如果是变长情况,row 和 batch 便会坍缩到一个维度,全用分块代替,数目为 sum_s_q 个,此时就需要用 row_stride 计算偏移。
row_offset_o 得到了分块图中一个 thread block 的行起始地址。可以看到,首先由 q_offset 计算 bidb 方面的偏移,m_block * kBlockM * params.o_row_stride 则进一步细化到 blockIdx.x 维度的分块的 row 行起始地址,然后才是 bidh * params.o_head_stride 对应 blockIdx.y 维度的 attention head 偏移。
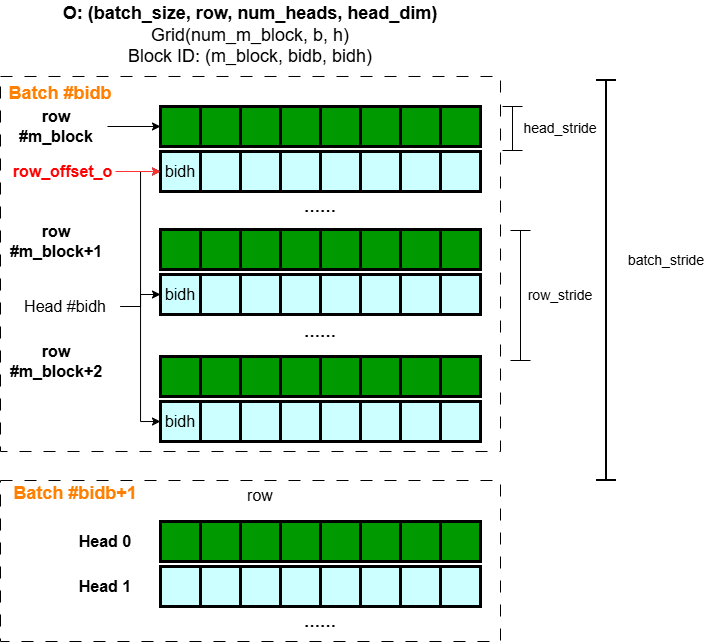
1 | |
k_offset 实现和 q_offset 实现原理一致,但二者差了一个 leftpad_k 变量,这牵扯到了 decoder 模型里 attention 中左填充(left padding)的相关知识。之所以采取左填充而不是更常见的右填充,是因为左填充时,k cache 的内容不会被填充字符阶段,能保证在计算 attention 时语义是完整且连续的,padding 的 token 分布在输出的两侧,处理时会更加方便。
1 | |
helper function
cutlass 相关
cutlass cute 数据搬移
图左边开始说起,
Q[kBlockM*kHeadDim] 从 global mem-> smem
-
定义 tensor 对象,
Tensor mQ = make_tensor(make_gmem_ptr(reinterpret_cast<Element*>(params.q_ptr)
+ binfo.q_offset(params.q_batch_stride, params.q_row_stride, bidb)),
make_shape(binfo.actual_seqlen_q, params.h, params.d),
make_stride(params.q_row_stride, params.q_head_stride, 1{}));
Tensor gQ = local_tile(mQ(, bidh, ), Shape<Int, Int )),>{},
make_coord(m_block, 0)); // (kBlockM, kHeadDim)
Tensor sQ = make_tensor(make_smem_ptr(reinterpret_cast<Element *>(smem
typename Kernel_traits::SmemLayoutQ{});using SmemLayoutAtomQ = decltype(
composition(Swizzle<kSwizzle, 3, 3>{},
// This has to be kBlockKSmem, using kHeadDim gives wrong results for d=128
Layout<Shape<_8, Int>,
Stride<Int, _1>>{}));
using SmemLayoutQ = decltype(tile_to_shape(
SmemLayoutAtomQ{},
Shape<Int, Int >{}));
一个TB处理一个绿块,mQ 确定了 batch size 这个维度下的数据,整个左边的绿柱子,gQ 就是红块,sQ 就是橙色块
-
创建 copy 对象,将 copy 任务按 threads 切分,得到当前 thread 负责 copy 的数据 tensor
typename Kernel_traits::GmemTiledCopyQKV gmem_tiled_copy_QKV;
auto gmem_thr_copy_QKV = gmem_tiled_copy_QKV.get_thread_slice(tidx);Tensor tQgQ = gmem_thr_copy_QKV.partition_S(gQ);
Tensor tQsQ = gmem_thr_copy_QKV.partition_D(sQ);using GmemLayoutAtom = Layout<Shape <Int<kNThreads / kGmemThreadsPerRow>, Int
>,
Stride<Int, _1>>;
using GmemTiledCopyQKV = decltype(
make_tiled_copy(Copy_Atom<Gmem_copy_struct, Element>{},
GmemLayoutAtom{},
Layout<Shape<_1, _8>>{})); // Val layout, 8 vals per read
using Gmem_copy_struct = std::conditional_t<
Has_cp_async,
SM80_CP_ASYNC_CACHEGLOBALcute::uint128_t,
AutoVectorizingCopyWithAssumedAlignment<128>;
tQ 指的是一个 pattern,应用到 gQ 得到的 tensor 就是 tQgQ
-
调用 copy 对象作数据copy
FLASH_NAMESPACE::copy<Is_even_MN, Is_even_K>(gmem_tiled_copy_QKV, tQgQ, tQsQ, tQcQ, tQpQ,
binfo.actual_seqlen_q - m_block * kBlockM);typename TiledCopy, typename Engine0, typename Layout0, typename Engine1, typename Layout1, typename Engine2, typename Layout2, typename Engine3, typename Layout3>
forceinline device void copy(TiledCopy tiled_copy, Tensor<Engine0, Layout0> const &S,
Tensor<Engine1, Layout1> &D, Tensor<Engine2, Layout2> const &identity_MN,
Tensor<Engine3, Layout3> const &predicate_K, const int max_MN=0) {
CUTE_STATIC_ASSERT_V(rank(S) == Int<3>{});
CUTE_STATIC_ASSERT_V(rank(D) == Int<3>{});
CUTE_STATIC_ASSERT_V(size<0>(S) == size<0>(D)); // MMA
CUTE_STATIC_ASSERT_V(size<1>(S) == size<1>(D)); // MMA_M
CUTE_STATIC_ASSERT_V(size<2>(S) == size<2>(D)); // MMA_K
// There’s no case where !Clear_OOB_K && Clear_OOB_MN
static_assert(!(Clear_OOB_MN && !Clear_OOB_K));
#pragma unroll
for (int m = 0; m < size<1>(S); ++m) {
if (Is_even_MN || get<0>(identity_MN(0, m, 0)) < max_MN) {
#pragma unroll
for (int k = 0; k < size<2>(S); ++k) {
if (Is_even_K || predicate_K(k)) {
cute::copy(tiled_copy, S(, m, k), D(, m, k));
} else if (Clear_OOB_K) {
cute::clear(D(, m, k));
}
}
} else if (Clear_OOB_MN) {
cute::clear(D(, m, _));
}
}
}
cutlass cute 作 copy 基本原理,定义 tiledcopy对象覆盖一片 tile 区域,tile 内部,按照设定的 thread layout 为thread自动计算数据地址,在tensor上水平、垂直循环该tile,覆盖整个tensor,cute自动根据tensor layout tiledcopy 确定tile循环次数
4 移动 kv cache
kv cache[num_block, block_size, num_heads, head_dim],先偏移了 num heads 方向,num block 和 block size 方向未定,
Tensor gK = local_tile(mK(_, bidh / params.h_h_k_ratio, _), Shape<Int<kBlockN>, Int<kHeadDim>>{},
                       make_coord(_, 0));  // (kBlockN, kHeadDim, nblocksN)
Tensor sK = make_tensor(sQ.data() + (Kernel_traits::Share_Q_K_smem ? 0 : size(sQ)),
                        typename Kernel_traits::SmemLayoutKV{});
Tensor gV = local_tile(mV(_, bidh / params.h_h_k_ratio, _), Shape<Int<kBlockN>, Int<kHeadDim>>{},
                       make_coord(_, 0));  // (kBlockN, kHeadDim, nblocksN)
Tensor sV = make_tensor(sK.data() + size(sK), typename Kernel_traits::SmemLayoutKV{});

      if (block_table == nullptr) {
            tKgK.data() = tKgK.data() + (-int(kBlockN * params.k_row_stride));
      }
5 smem 到 reg 搬移
TiledMMa
using MMA_Atom_Arch = std::conditional_t<
    std::is_same_v<elem_type, cutlass::half_t>,
    MMA_Atom<SM80_16x8x16_F32F16F16F32_TN>,
    MMA_Atom<SM80_16x8x16_F32BF16BF16F32_TN>
>;
using TiledMma = TiledMMA<
    typename Base::MMA_Atom_Arch,
    Layout<Shape<Int<kNWarps>,_1,_1>>,  // 4x1x1 or 8x1x1 thread group
    Tile<Int<16 * kNWarps>, _16, _16>>;

typename Kernel_traits::TiledMma tiled_mma;
auto thr_mma = tiled_mma.get_thread_slice(tidx);
Tensor tSrQ  = thr_mma.partition_fragment_A(sQ);                           // (MMA,MMA_M,MMA_K)
Tensor tSrK  = thr_mma.partition_fragment_B(sK);                           // (MMA,MMA_N,MMA_K)
Tensor tOrVt  = thr_mma.partition_fragment_B(sVtNoSwizzle);                // (MMA, MMA_K,MMA_N)

Tensor tSgS  = thr_mma.partition_C(gP);

Tensor acc_o = partition_fragment_C(tiled_mma, Shape<Int<kBlockM>, Int<kHeadDim>>{});  // MMA, MMA_M, MMA_K

//
// Copy Atom retiling
//

auto smem_tiled_copy_Q = make_tiled_copy_A(typename Kernel_traits::SmemCopyAtom{}, tiled_mma);
auto smem_thr_copy_Q = smem_tiled_copy_Q.get_thread_slice(tidx);
// if (cute::thread0()) {smem_thr_copy_Q.print_all();}
Tensor tSsQ = smem_thr_copy_Q.partition_S(sQ);
// if (cute::thread0()) {print(tSsQ.layout()); printf("\n");}

auto smem_tiled_copy_K = make_tiled_copy_B(typename Kernel_traits::SmemCopyAtom{}, tiled_mma);
auto smem_thr_copy_K = smem_tiled_copy_K.get_thread_slice(tidx);
Tensor tSsK = smem_thr_copy_K.partition_S(sK);

auto smem_tiled_copy_V = make_tiled_copy_B(typename Kernel_traits::SmemCopyAtomTransposed{}, tiled_mma);
auto smem_thr_copy_V = smem_tiled_copy_V.get_thread_slice(tidx);
Tensor tOsVt = smem_thr_copy_V.partition_S(sVt);


if (!A_in_regs) { cute::copy(smem_tiled_copy_A, tCsA(_, _, _0{}), tCrA_copy_view(_, _, _0{})); }
if (!B_in_regs) { cute::copy(smem_tiled_copy_B, tCsB(_, _, _0{}), tCrB_copy_view(_, _, _0{})); }
#pragma unroll
for (int i = 0; i < size<2>(tCrA); ++i) {
    if (i < size<2>(tCrA) - 1) {
        if (!A_in_regs) { cute::copy(smem_tiled_copy_A, tCsA(_, _, i + 1), tCrA_copy_view(_, _, i + 1)); }
        if (!B_in_regs) { cute::copy(smem_tiled_copy_B, tCsB(_, _, i + 1), tCrB_copy_view(_, _, i + 1)); }
    }
    cute::gemm(tiled_mma, tCrA(_, _, i), tCrB(_, _, i), acc);
}
compute_attn_1rowblock
附录
cutlass 相关
cutlass Layout
详细介绍可参考 reed 大佬的 cute 之 layout。这里不作过多阐述。一言以蔽之,Layout 就是对 tensor 在计算机内存储空间的一个描述代数,表达了 tensor 从一个多维坐标到实际地址空间(偏移量)的映射情况。Layout 是一个可以实现将逻辑坐标映射到索引坐标(offset表示),它包含 Shape 和 Stride 两部分。其中 Shape 描述分块大小、结构形状。Stride描述块内或块间的数据排列步长。Shape 和 Stride 都是可以层级地嵌套表示。